资源简介
PHP蜘蛛池搭建教程:从零开始构建高效新闻聚合平台
蜘蛛池是一种通过批量管理域名与内容源,引导搜索引擎爬虫持续抓取目标页面的技术架构。在新闻聚合场景中,蜘蛛池能够将分散的新闻源统一调度,提升收录效率与索引更新频率。本文以PHP为开发语言,从环境准备、数据库设计、爬虫调度、内容分发四个层面,完整阐述蜘蛛池的搭建流程。
一、环境准备与基础依赖
操作系统建议使用Linux发行版,如Ubuntu 22.04或CentOS 7以上。Web服务器采用Nginx配合PHP-FPM,PHP版本不低于8.0。需要安装的PHP扩展包括:curl、dom、mbstring、pdo_mysql、redis、json。数据库使用MySQL 8.0,缓存层使用Redis 6.0以上。
Nginx配置中需开启伪静态支持,将蜘蛛请求统一转发至入口文件。示例配置片段如下:
location / {
    try_files $uri $uri/ /index.php?$query_string;
}
二、数据库结构设计
蜘蛛池核心数据表包括:域名表、新闻源表、抓取队列表、内容表、蜘蛛日志表。域名表存储待推广的站点域名及其权重状态。新闻源表记录RSS地址或列表页URL。抓取队列采用优先级队列,支持定时重置。内容表存放已抓取的标题、正文、发布时间、来源URL。蜘蛛日志表记录每次爬虫访问的IP、User-Agent、请求时间、响应码。
建表示例:
CREATE TABLE spider_domain (
id INT AUTO_INCREMENT PRIMARY KEY,
domain VARCHAR(255) NOT NULL,
weight TINYINT DEFAULT 1,
status TINYINT DEFAULT 1,
created_at DATETIME DEFAULT CURRENT_TIMESTAMP
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
CREATE TABLE news_queue (
id BIGINT AUTO_INCREMENT PRIMARY KEY,
source_url VARCHAR(500) NOT NULL,
priority TINYINT DEFAULT 5,
retry_count TINYINT DEFAULT 0,
next_fetch DATETIME,
INDEX idx_next_fetch (next_fetch)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
三、爬虫调度模块实现
爬虫调度采用主从模式。主进程从news_queue中读取next_fetch小于当前时间的记录,按priority排序,每次取出50条,分配给从进程。从进程使用curl多线程抓取,设置超时时间为10秒,并发数控制在20以内。抓取到的HTML通过DOMDocument解析,提取标题、正文、发布时间。正文清洗规则包括去除script、style标签,过滤广告div,保留段落标签。
关键代码逻辑:
function fetchNews($url) {
$ch = curl_init();
curl_setopt_array($ch, [
CURLOPT_URL => $url,
CURLOPT_RETURNTRANSFER => true,
CURLOPT_TIMEOUT => 10,
CURLOPT_USERAGENT => 'Mozilla/5.0 (compatible; NewsBot/1.0)'
]);
$html = curl_exec($ch);
$httpCode = curl_getinfo($ch, CURLINFO_HTTP_CODE);
curl_close($ch);
if ($httpCode !== 200) {
return false;
}
$dom = new DOMDocument();
libxml_use_internal_errors(true);
$dom->loadHTML(mb_convert_encoding($html, 'HTML-ENTITIES', 'UTF-8'));
libxml_clear_errors();
$xpath = new DOMXPath($dom);
$title = $xpath->query('//h1')->item(0)->textContent ?? '';
$content = '';
foreach ($xpath->query('//p') as $p) {
$content .= '' . trim($p->textContent) . '
';
}
return ['title' => $title, 'content' => $content];
}
四、内容分发与蜘蛛诱导
抓取到的新闻内容存入内容表后,需生成静态化页面或伪静态URL。每个域名对应一个独立的模板目录,模板中嵌入随机内链与锚文本。内链指向同一蜘蛛池中的其他域名,形成闭环。页面底部添加站点地图链接与RSS订阅地址,便于爬虫发现新内容。
为提升蜘蛛访问频率,需在robots.txt中允许所有爬虫,并设置Sitemap地址。同时配置Nginx日志分析脚本,每日统计百度、Google、Bing等爬虫的访问次数与抓取深度。若某域名连续三天无爬虫访问,则自动降低其权重,并增加该域名下页面的内链数量。
五、性能优化与反屏蔽策略
使用Redis缓存已抓取的新闻内容,避免重复解析。队列消费采用阻塞式读取,减少数据库压力。对于目标站点的反爬机制,需轮换User-Agent池,并设置随机请求间隔。建议每抓取100个页面后暂停5至10秒。若遇到验证码,则将该源标记为不可用,并转入人工审核队列。
六、监控与维护
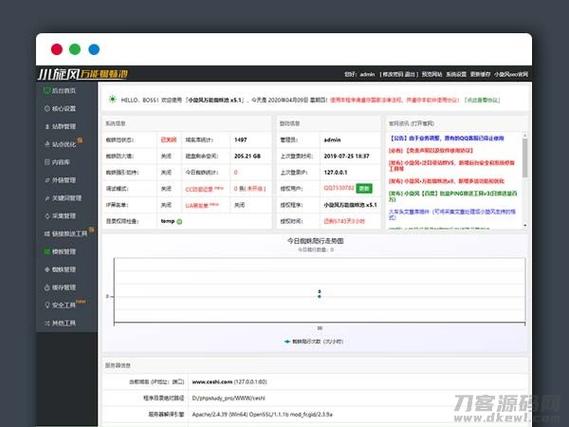
搭建简易监控面板,展示以下指标:队列积压数量、今日抓取成功数、失败重试次数、各爬虫访问量、域名权重分布。设置告警阈值,当队列积压超过5000或失败率高于30%时,发送邮件通知。每周清理一次过期日志与重复内容,保持数据库高效运行。
七、法律与合规提示
蜘蛛池技术仅可用于抓取公开授权的内容源。搭建前需确认目标站点的robots.txt协议与版权声明。禁止抓取个人隐私数据、付费墙内容或明确禁止爬取的页面。新闻聚合平台应注明来源出处,并遵守著作权法合理使用条款。
通过以上七个步骤,可完成一个基于PHP的蜘蛛池系统。实际部署时需根据服务器配置与目标源数量调整并发参数与队列长度。持续观察蜘蛛日志,迭代内链策略与更新频率,方能实现高效稳定的新闻聚合效果。
亮点功能
- ✦ 蜘蛛池参数调整引爆流量:最新修改技巧让新闻秒收录
- ✦ 蜘蛛池参数调整引爆流量:最新修改技巧让新闻秒收录
- ✦ 蜘蛛池参数调整引爆流量:最新修改技巧让新闻秒收录