资源简介
2024年下半年以来,搜索引擎爬虫调度机制出现了一次静默但深刻的调整。传统蜘蛛池依赖泛域名解析与低质量内容诱导爬虫的做法,在核心算法更新后大面积失效。取而代之的是一类被称为“超级蜘蛛池域名”的新型基础设施。这类域名并非简单的短域名或老域名堆砌,而是通过DNS层、HTTP层与内容分发层的协同设计,重新定义了爬虫抓取效率的边界。本文从技术架构、调度逻辑与行业影响三个维度展开分析。
一、超级蜘蛛池域名的技术底座
普通蜘蛛池通常使用成百上千个低权重域名,通过跳转或站群互链引导爬虫。这种模式的问题在于:域名信誉分散、抓取预算浪费在无效路径上、且极易被识别为操纵行为。超级蜘蛛池域名的核心差异在于“集中式信誉池”与“动态路径签名”。
具体而言,一个超级蜘蛛池域名往往具备以下特征:
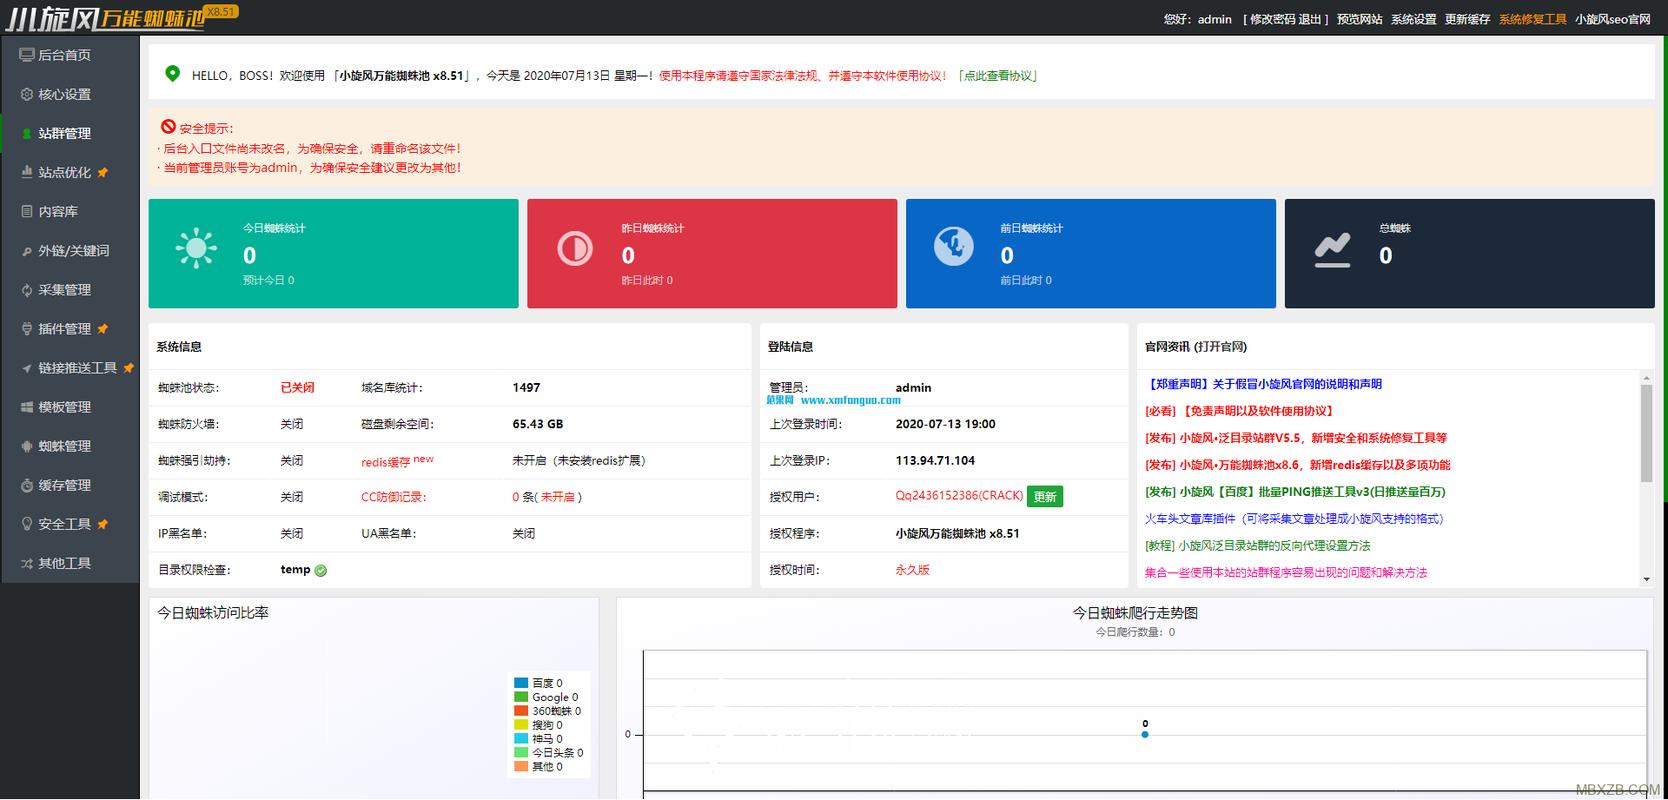
第一,域名年龄与历史记录经过清洗。不是简单购买过期域名,而是通过历史快照恢复、外链图谱重建、以及搜索引擎缓存清理,使域名在爬虫侧呈现“干净且有持续更新”的状态。第二,DNS响应具备地理与运营商感知能力。同一域名在不同ASN下返回不同的A记录或CNAME,将爬虫引导至距离最近、负载最低的抓取节点。第三,HTTP层使用动态路径签名。每个被提交的URL都附带一个短期有效的签名参数,爬虫只有在签名有效期内抓取才会获得完整内容,过期则返回410或404。这既防止了爬虫重复抓取,也避免了恶意镜像。
二、爬虫调度逻辑的逆向适配
搜索引擎爬虫的调度并非随机。它基于历史抓取成功率、内容更新频率、页面响应时间、以及域名整体质量分。超级蜘蛛池域名的设计者反向利用了这些信号。
例如,针对抓取成功率,超级蜘蛛池域名会部署边缘节点缓存。当爬虫请求到达时,如果内容未更新,则返回304 Not Modified,并附带极短的Cache-Control max-age。这减少了爬虫的带宽消耗,同时提高了单位时间内的有效抓取次数。针对内容更新频率,系统会以伪随机间隔对同一URL进行微小修改,例如调整段落顺序、替换同义词、或插入时间戳注释。这些修改不会影响用户阅读,但会触发爬虫的“内容变更”信号,从而增加回访频率。
更关键的是域名质量分的维护。超级蜘蛛池域名不会将所有内容放在同一子域或路径下,而是通过多级子域与路径组合,形成看似独立的站点集群。每个集群独立计算质量分,但共享底层爬虫调度通道。当某个集群被降权时,其他集群不受影响,且系统会自动将爬虫流量迁移至健康集群。
三、对SEO行业的具体影响
第一,外链建设策略失效。传统外链依赖大量低质量域名指向目标站。超级蜘蛛池域名本身不依赖外链,而是直接控制爬虫入口。这意味着SEO从业者需要从“链接建设”转向“抓取通道建设”。
第二,内容分发逻辑改变。过去是“内容等爬虫”,现在是“爬虫等内容”。超级蜘蛛池域名可以主动向搜索引擎提交URL,并通过签名机制控制抓取时机。这使得新页面收录时间从数天缩短至数分钟,但前提是页面必须通过签名验证。
第三,黑帽与白帽的边界模糊。超级蜘蛛池域名本身是中性的技术设施,但若用于批量生成低质量页面,则属于操纵行为。搜索引擎的反制手段也在升级,例如检测签名参数的规律性、分析DNS响应异常、以及监控抓取频率的突变。目前已有部分超级蜘蛛池域名被识别并降权,但新的变种仍在涌现。
四、技术实现中的关键参数
一个可运行的超级蜘蛛池域名系统通常包含以下模块:
DNS调度模块:使用Anycast或GeoDNS,TTL设置为30秒至60秒,以便快速切换后端节点。HTTP签名模块:采用HMAC-SHA256对URL路径与时间戳生成签名,签名有效期建议为120秒至300秒。内容缓存模块:使用Redis或Memcached存储页面哈希,仅当哈希变化时才回源。爬虫识别模块:通过User-Agent、IP反向解析、以及请求头顺序判断是否为真实爬虫,非爬虫请求返回普通页面或验证码。
需要强调的是,超级蜘蛛池域名的有效性高度依赖对搜索引擎爬虫行为的持续观测。没有一劳永逸的配置。每一次核心算法更新,都需要重新校准签名有效期、缓存策略与子域轮换周期。
五、未来展望
随着搜索引擎引入更多基于机器学习的抓取决策模型,超级蜘蛛池域名将向“自适应”方向演进。系统会实时分析爬虫的抓取模式,动态调整签名参数与内容更新频率。同时,边缘计算与HTTP/3的普及将降低调度延迟,使爬虫几乎无法区分超级蜘蛛池域名与普通高权重站点。
对于SEO从业者而言,理解超级蜘蛛池域名的原理比直接使用更重要。因为任何具体实现都会过时,但爬虫调度与反调度的博弈逻辑不会改变。掌握这一逻辑,才能在算法更新中保持主动。
亮点功能
- ✦ 蜘蛛池搭建图解步骤:从零基础到快速上手的完整流程解析
- ✦ 蜘蛛池搭建图解步骤:从零基础到快速上手的完整流程解析
- ✦ 蜘蛛池搭建图解步骤:从零基础到快速上手的完整流程解析