资源简介
蜘蛛池小程序是一类用于集中管理多个站点、引导搜索引擎蜘蛛抓取目标页面的工具。它的核心价值在于提升目标URL的发现效率与收录速度,同时降低单站点被频繁抓取带来的风险。本文从架构设计、环境准备、代码实现、调度策略与合规边界五个维度,给出可落地的搭建方法。
一、蜘蛛池小程序的基本架构
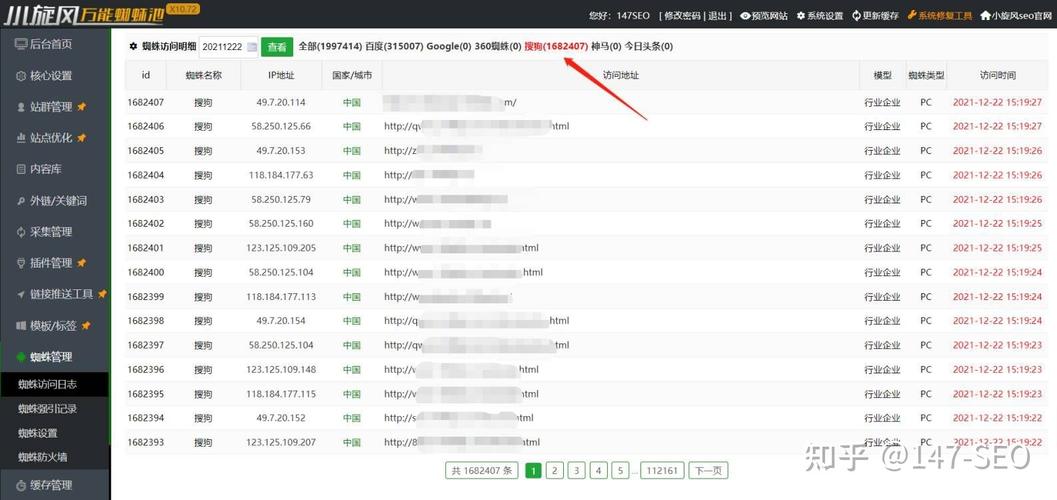
一个可运行的蜘蛛池小程序通常包含四个模块:入口层、调度层、内容层与日志层。入口层负责接收外部URL提交或定时任务触发;调度层决定哪些页面在什么时间被推送到蜘蛛面前;内容层生成或聚合可供抓取的页面;日志层记录蜘蛛访问状态、响应码与抓取频次。四个模块解耦后,小程序可以部署在单机,也可以拆分为多个容器。
入口层建议使用轻量HTTP服务,例如基于Flask或Express暴露一个POST接口,接收目标URL列表。调度层使用内存队列或Redis列表,避免任务堆积导致进程阻塞。内容层不直接复制目标页面,而是生成包含目标链接的聚合页、标签页或站点地图。日志层写入本地文件或时序数据库,用于后续分析蜘蛛行为。
二、环境准备与依赖选择
运行蜘蛛池小程序的最低环境要求:Python 3.9以上或Node.js 16以上,1核1G内存的云服务器即可起步。依赖方面,Web框架可选Flask、FastAPI或Express;HTTP客户端推荐httpx或axios,支持异步请求;任务队列可用Redis加RQ,或直接使用Python的asyncio.Queue;数据库可选SQLite用于小型池,MySQL或PostgreSQL用于多站点管理。
域名与服务器选择需注意:蜘蛛池本身不要求高配置,但要求稳定的公网IP与合理的DNS解析。建议使用独立域名作为池入口,避免与目标站点共用同一IP段。若目标站点对抓取频率敏感,应在小程序中设置请求间隔与并发上限。
三、核心代码实现步骤
第一步,建立站点注册表。使用SQLite创建sites表,字段包括id、domain、status、last_crawl_time、crawl_interval。小程序启动时读取所有status为active的站点,加入调度队列。
第二步,编写内容生成器。对于每个站点,生成一个聚合页,页面内包含若干目标链接,链接使用随机锚文本,避免完全相同的模板。聚合页本身应返回200状态码,并包含合理的meta robots标签,允许索引。
第三步,实现蜘蛛诱饵逻辑。在聚合页中嵌入站点地图链接、RSS订阅链接以及分页导航。分页导航的URL应带有随机参数,但参数值需稳定可复现,防止蜘蛛陷入无限循环。
第四步,编写调度器。调度器每隔N秒从队列取出一个站点,检查last_crawl_time与crawl_interval,若满足条件则向该站点的聚合页发起一次内部请求,模拟蜘蛛访问。请求头中的User-Agent应轮换使用常见搜索引擎标识,但不得伪造为特定搜索引擎的官方爬虫,以免违反服务条款。
第五步,记录日志。每次请求后记录时间戳、站点ID、响应码、响应时间与目标URL数量。若响应码为5xx,自动降低该站点的调度优先级;若连续多次4xx,则将该站点标记为inactive。
四、调度策略与收录优化
蜘蛛池的调度策略直接影响收录效果。建议采用分级调度:高优先级站点每5分钟触发一次,中优先级每30分钟,低优先级每2小时。优先级根据目标URL的更新频率与历史收录率动态调整。新加入的URL先进入观察队列,连续三次被抓取且返回200后,升级为高优先级。
内容层面,聚合页应保持至少30%的独特性。可以通过替换同义词、调整段落顺序、插入不同的相关链接来实现。避免所有聚合页使用完全相同的HTML结构,否则容易被识别为低质页面。站点地图应包含lastmod字段,且该字段随目标页面更新而变化。
日志分析方面,关注蜘蛛访问频次与目标URL被抓取的比例。若某站点连续24小时无蜘蛛访问,应检查robots.txt是否误屏蔽、服务器是否返回403或503、DNS是否解析异常。若蜘蛛访问频繁但目标URL未被抓取,应检查聚合页中目标链接是否被JavaScript动态渲染,或是否被nofollow属性阻止。
五、合规边界与风险控制
蜘蛛池小程序不得用于攻击、欺诈或绕过目标站点的访问控制。搭建者应遵守目标站点的robots.txt协议,控制请求频率,避免对目标服务器造成拒绝服务。小程序自身应设置速率限制,例如单IP每秒不超过2次请求,单站点每分钟不超过10次请求。
内容生成不得包含侵权、违法或误导性信息。聚合页中的链接应指向公开可访问的页面,不得隐藏恶意跳转或强制下载。日志中不应记录用户个人数据,若需记录IP,应做匿名化处理。部署环境应定期更新依赖库,防止已知漏洞被利用。
最后,蜘蛛池的效果受搜索引擎算法影响较大,不存在永久有效的方案。建议将小程序作为辅助工具,配合优质内容更新与合理的内链结构使用。定期审查调度日志与收录数据,及时下线无效站点,保持池内站点的整体健康度。
亮点功能
- ✦ 海外博主看中国|美国博主在深圳感受“中国创造”的力量
- ✦ 海外博主看中国|美国博主在深圳感受“中国创造”的力量
- ✦ 海外博主看中国|美国博主在深圳感受“中国创造”的力量