资源简介
在当前互联网内容生态中,数据抓取与内容生成的效率直接决定了站点运营的竞争力。小霸王蜘蛛池采集作为一种针对搜索引擎蜘蛛行为进行优化的技术方案,其核心价值在于通过分布式爬虫架构与智能内容处理流程,实现从目标站点批量获取数据并转化为可索引内容的目标。本文将从技术实现、采集策略、内容生成逻辑以及实际部署要点四个维度展开分析。
一、小霸王蜘蛛池采集的技术架构
小霸王蜘蛛池采集并非单一爬虫程序,而是由调度中心、爬虫节点、代理池、去重模块与内容生成引擎组成的协同系统。调度中心负责分配待抓取URL队列,爬虫节点基于异步IO模型并发请求目标页面,代理池则通过动态IP轮换规避目标站点的反爬机制。去重模块采用SimHash与布隆过滤器双重校验,确保相同内容不会重复进入生成流程。
在数据落盘环节,系统将原始HTML、提取后的正文、结构化元数据分别存储。正文提取采用基于文本密度的算法,剔除导航栏、广告位与页脚噪声。元数据包括发布时间、作者、关键词密度等字段,为后续内容重组提供依据。
二、采集策略与反爬对抗
小霸王蜘蛛池采集的采集策略分为广度优先与深度优先两种模式。广度优先适用于栏目页与列表页的快速遍历,深度优先则用于详情页的逐层下钻。实际运行中,系统根据目标站点的robots.txt与页面更新频率动态调整抓取间隔,避免对目标服务器造成过大压力。
反爬对抗方面,系统内置了User-Agent轮换、Referer伪造、Cookie池维护以及请求频率随机化等功能。对于采用JavaScript渲染的页面,采集节点会调用无头浏览器内核执行必要脚本后再提取内容。针对验证码拦截,系统支持接入第三方打码平台或使用行为模拟方式绕过简单验证。
三、智能内容生成逻辑
采集所得原始数据并不能直接用于站点发布,必须经过内容生成引擎的处理。小霸王蜘蛛池采集的内容生成逻辑包含三个层次:第一层是段落级重组,将不同来源的相似段落进行语义对齐后合并;第二层是关键词替换与同义词扩展,在保持原意的前提下降低重复率;第三层是模板化输出,根据预设的文章结构填充标题、导语、正文与结尾。
生成过程中,系统会计算内容的可读性分数与信息密度。可读性分数基于句长分布与连接词使用频率,信息密度则通过实体识别与关系抽取结果衡量。只有同时满足阈值的内容才会被标记为可发布状态。此外,系统支持为每篇文章自动生成TDK标签,即标题、描述与关键词,以提升搜索引擎收录效率。
四、部署要点与性能调优
部署小霸王蜘蛛池采集时,建议将爬虫节点与内容生成节点分离部署。爬虫节点配置高并发网络IO与充足代理带宽,生成节点则侧重CPU与内存资源。数据库层面,使用Redis作为URL队列与去重缓存,MongoDB或MySQL存储结构化内容。
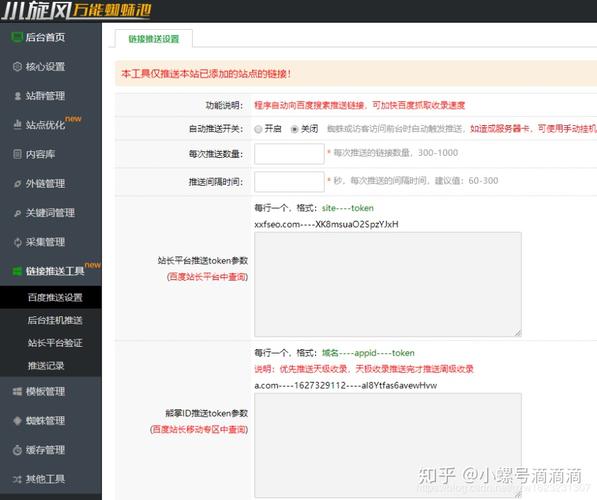
性能调优方面,重点调整三个参数:并发连接数、单域名请求间隔与内容生成批次大小。并发连接数过高会触发目标站点封禁,过低则影响采集效率。单域名请求间隔建议设置为2至5秒随机值。内容生成批次大小控制在50至100篇之间,避免内存溢出。
监控体系需要覆盖采集成功率、去重率、生成合格率与发布失败率四个指标。当采集成功率低于85%时,应检查代理池可用性或目标站点结构变化。当生成合格率低于70%时,需调整同义词库或段落重组算法。
五、合规性与风险控制
使用小霸王蜘蛛池采集必须遵守目标站点的robots协议与相关法律法规。系统应默认尊重robots.txt中的Disallow指令,并对受版权保护的内容进行标记。建议在生成内容中保留原始来源的引用信息,或对采集数据进行深度改写以形成独立表达。
风险控制还包括防止采集行为被识别为恶意攻击。系统应设置单IP请求上限、异常流量告警与自动降速机制。对于需要登录才能访问的页面,除非获得明确授权,否则不应纳入采集范围。
综上所述,小霸王蜘蛛池采集是一套融合了分布式爬虫、反爬对抗、内容重组与质量评估的完整技术方案。其专业价值不在于单一环节的突破,而在于各模块之间的协同效率。只有在采集策略、生成逻辑与合规框架三者之间取得平衡,才能实现可持续的高效数据抓取与内容生成。
亮点功能
- ✦ 蜘蛛池教程视频大全:从入门到精通,全网最全实战视频合集重磅发布
- ✦ 蜘蛛池教程视频大全:从入门到精通,全网最全实战视频合集重磅发布
- ✦ 蜘蛛池教程视频大全:从入门到精通,全网最全实战视频合集重磅发布