资源简介
蜘蛛池是一套通过大量站点互相链接、集中向目标页面输送爬虫抓取请求的流量调度系统。本文围绕蜘蛛池怎么操作视频中的核心步骤,拆解从环境准备、程序部署、域名解析、模板配置到日志监控的完整流程,并给出可复用的参数建议与风险控制方法。
一、蜘蛛池的基本结构与运行逻辑
蜘蛛池通常由三层组成:入口层负责接收搜索引擎爬虫请求,中间层负责在站群之间分配链接权重,目标层负责将爬虫引导至需要收录的页面。其运行逻辑并非直接伪造流量,而是利用大量低权重域名构建链接网络,让爬虫在短时间内发现并抓取目标URL。操作视频中常见的演示环境多为Linux服务器搭配Nginx、PHP与MySQL,部分方案使用Redis做队列缓存。
二、操作前的环境准备
在观看蜘蛛池怎么操作视频之前,需要先确认以下基础条件:
- 服务器:建议使用独立IP的VPS或独立服务器,避免共享IP被批量惩罚。配置至少2核4G,带宽5M以上。
- 域名:准备一批已备案或可正常解析的域名,数量根据目标规模决定。泛解析可提高子域名利用率。
- 程序:主流蜘蛛池程序包括基于PHP的站群系统、Python爬虫调度脚本以及部分商业源码。选择时需确认是否支持自定义UA识别与日志回传。
- 数据库:MySQL 5.7以上,用于存储域名、模板、跳转规则与访问日志。
- 运行环境:Nginx + PHP 7.4或8.0,开启伪静态与URL重写。
三、蜘蛛池怎么操作视频中的部署步骤
1. 域名解析与泛解析配置
在DNS服务商处添加A记录,将主域名指向服务器IP。随后添加泛解析记录,例如 *.example.com 指向同一IP。泛解析的作用是让任意子域名都能访问蜘蛛池入口,从而扩大爬虫触达面。操作视频中通常会演示在Cloudflare或阿里云DNS中添加两条记录:一条主机记录为 @,一条为 *。
2. 上传程序与数据库导入
通过SSH或宝塔面板将蜘蛛池程序上传至网站根目录,解压后修改数据库配置文件,填写数据库地址、用户名、密码与库名。随后访问 http://域名/install 执行安装,或直接导入提供的SQL文件。安装完成后删除install目录,避免被扫描。
3. Nginx伪静态与跳转规则
在站点配置中加入伪静态规则,使URL结构对爬虫友好。常见规则如下:
location / {
    if (!-e $request_filename) {
        rewrite ^/(.*)$ /index.php?$1 last;
    }
}
同时配置UA识别逻辑,将百度、搜狗、Google等爬虫UA与普通用户UA区分处理。爬虫访问时返回目标页面或跳转链接,普通用户访问时返回正常内容或404,避免被人工举报。
4. 模板与内容配置
蜘蛛池的模板分为入口页、列表页与内容页。入口页用于吸引爬虫抓取,列表页用于生成大量内链,内容页用于承载目标URL。操作视频中会演示在后台添加模板变量,例如 {title}、{keywords}、{content},并设置随机组合规则。内容建议采集或伪原创,避免完全重复。
5. 链接调度与目标URL注入
在后台添加需要引蜘蛛的目标URL,设置权重与每日抓取次数。系统会根据队列顺序,将目标URL插入到随机内容页的正文或底部链接中。部分程序支持设置跳转概率,例如爬虫访问10次中有3次跳转到目标页,其余返回普通内容。
四、日志监控与效果验证
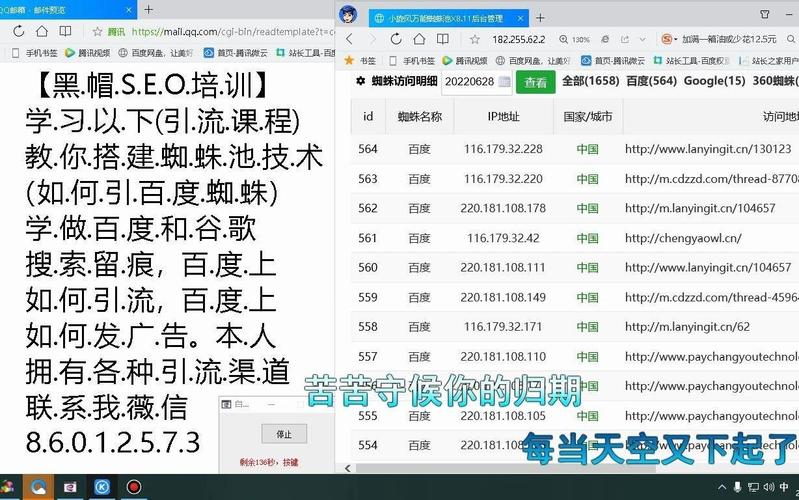
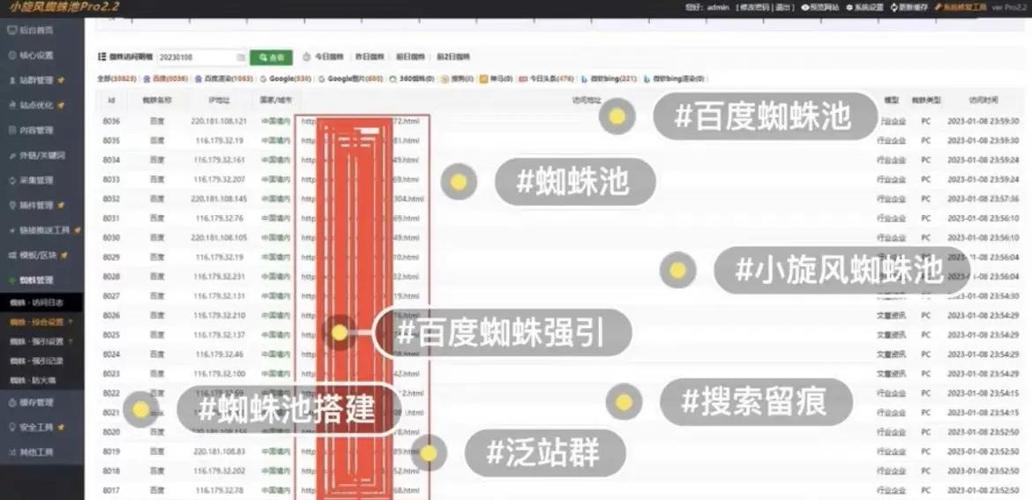
部署完成后,需要通过日志验证蜘蛛池是否正常工作。查看Nginx访问日志,筛选百度蜘蛛UA:
grep "Baiduspider" /www/wwwlogs/access.log | awk '{print $1}' | sort | uniq -c | sort -rn | head -20
同时检查目标URL的抓取记录。若连续24小时无爬虫访问,需排查DNS解析、防火墙、UA识别规则或程序队列是否阻塞。操作视频中常建议开启实时日志面板,观察爬虫IP来源与抓取频率。
五、常见问题与风险控制
- 域名被墙:泛解析域名若被大量滥用,可能触发DNS污染。建议分批解析,控制单域名子域数量。
- 服务器被封:避免在单一IP上部署过多站点,使用CDN或反向代理分散入口。
- 程序后门:非官方渠道下载的蜘蛛池源码可能包含后门,建议在沙箱环境测试后再上线。
- 搜索引擎惩罚:蜘蛛池属于灰色操作,目标站点若被识别为作弊,可能被降权或删除索引。应控制引蜘蛛频率,避免短时间大量异常请求。
六、操作视频中的参数参考
根据多数蜘蛛池怎么操作视频的演示,以下参数可作为初始配置参考:
- 单域名每日抓取上限:500至2000次
- 目标URL跳转概率:20%至40%
- 队列并发数:10至30
- 日志保留周期:7天
- 泛解析子域数量:每域名不超过200个
实际运行时需根据服务器负载与爬虫响应速度动态调整。若CPU占用持续超过70%,应降低并发或增加缓存层。
七、总结
蜘蛛池的操作核心在于域名解析、程序部署、UA识别、链接调度与日志监控五个环节。通过视频教程可以快速完成基础搭建,但长期稳定运行依赖参数调优与风险控制。建议在合法合规的前提下,将蜘蛛池作为辅助收录工具,而非唯一引流手段。目标页面的内容质量与站点结构仍是决定收录效果的根本因素。
亮点功能
- ✦ 蜘蛛池搭建多久能生成一条新闻
- ✦ 蜘蛛池搭建多久能生成一条新闻
- ✦ 蜘蛛池搭建多久能生成一条新闻