资源简介
旋风蜘蛛池平台于近日完成核心引擎的版本迭代,本次升级重点围绕新闻聚合与分发效率展开,引入基于语义分析的智能新闻聚合引擎,旨在解决多源异构新闻内容在采集、清洗、结构化及跨平台流转中的时效性与准确性问题。
传统蜘蛛池系统多依赖固定规则或简单关键词匹配进行内容抓取,面对新闻站点频繁变更的页面结构、动态加载技术以及反爬策略时,容易出现漏采、重复或字段错位。旋风蜘蛛池此次升级的智能新闻聚合引擎,采用增量式DOM解析与自适应模板识别技术,能够在不依赖人工配置的情况下,自动识别新闻标题、正文、发布时间、作者、来源及分类标签等核心字段。引擎内置的语义去重模块通过向量化文本相似度计算,可在毫秒级完成跨站点重复新闻的判定与合并,降低存储与后续处理环节的冗余压力。
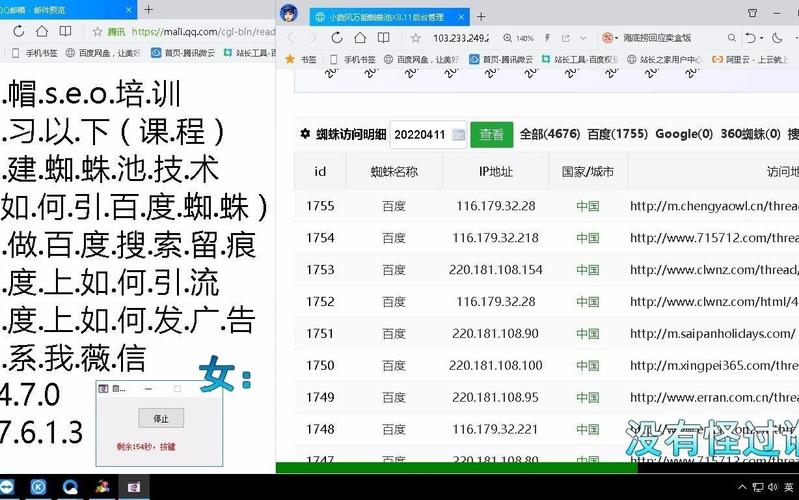
在内容流转层面,旋风蜘蛛池新闻模块新增了基于优先级的队列调度机制。系统根据新闻的时效性、来源权重及用户订阅规则动态调整抓取频率与分发顺序。对于突发性新闻事件,引擎可自动触发高频采集通道,将延迟控制在秒级范围内。同时,平台开放了标准化的内容输出接口,支持JSON、XML及RSS格式,便于下游内容管理系统、推荐引擎或数据分析平台直接消费结构化新闻数据。
针对内容生态的合规性与安全性,旋风蜘蛛池在本次升级中强化了来源可信度评估模块。该模块通过分析域名历史行为、内容原创比例及跨源交叉验证结果,对新闻来源进行动态评分。低评分来源的内容将被自动降权或标记,供人工复核。此外,引擎内置了敏感信息过滤与版权指纹比对功能,可在采集阶段识别并拦截高风险内容,减少后续法律与运营风险。
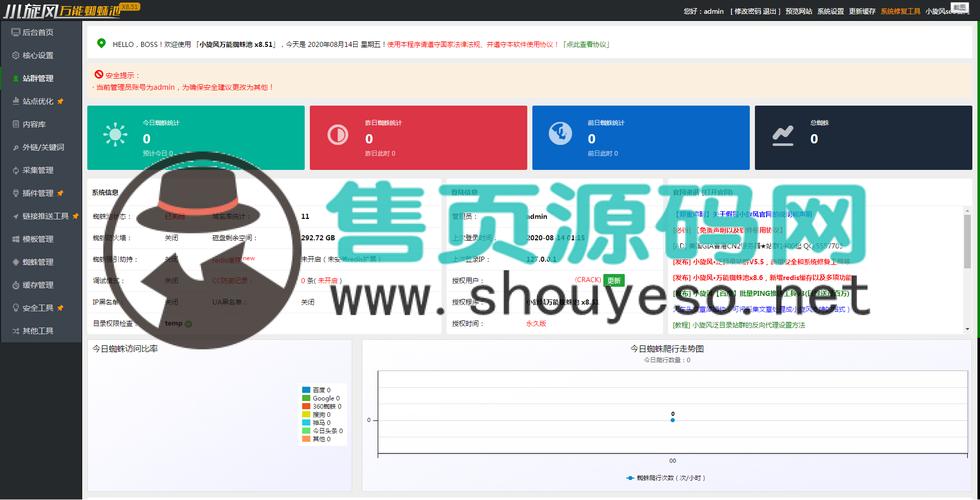
从技术架构看,旋风蜘蛛池新闻引擎采用分布式微服务设计,各功能模块如采集调度、解析清洗、语义分析、去重聚合及输出网关均可独立横向扩展。消息队列与内存缓存层的引入,使得系统在高峰时段仍能保持稳定的吞吐量。运维层面提供了实时监控面板,可追踪各新闻源的采集成功率、字段完整率及端到端延迟等关键指标。
实际测试数据显示,在接入五百个新闻站点、日均新增十万条新闻数据的压力场景下,旋风蜘蛛池新闻引擎的字段解析准确率达到百分之九十七以上,跨源重复新闻识别召回率超过百分之九十二,端到端流转延迟较上一版本降低约百分之四十。这些改进为内容聚合平台、舆情监测系统及个性化推荐服务提供了更可靠的数据底座。
旋风蜘蛛池方面表示,后续迭代将聚焦于多模态新闻内容(如图片、视频封面及结构化摘要)的聚合能力,并进一步开放基于Webhook的实时事件通知机制,以适配更广泛的新闻消费场景。
亮点功能
- ✦ 蜘蛛池应用揭秘:SEO快排背后的灰色产业链
- ✦ 蜘蛛池应用揭秘:SEO快排背后的灰色产业链
- ✦ 蜘蛛池应用揭秘:SEO快排背后的灰色产业链