资源简介
蜘蛛池源码是一套用于集中管理大量域名并引导搜索引擎爬虫持续抓取目标站点的程序系统。其核心目标并非单纯增加外链数量,而是通过可控的域名集群与内容调度机制,提升目标页面被搜索引擎发现与收录的效率。本文从架构设计、核心模块、数据库结构、部署要点及风险控制五个维度展开分析,面向具备一定后端开发与SEO基础的读者。
一、蜘蛛池源码的整体架构
典型的蜘蛛池源码采用分层架构,自上而下分为接入层、调度层、内容层与数据层。接入层负责接收来自不同域名的HTTP请求,通常使用Nginx或OpenResty做反向代理与域名泛解析。调度层是蜘蛛池源码的核心,决定哪个域名响应哪次爬虫请求,以及返回何种内容。内容层负责生成或抽取页面模板,避免所有域名返回完全相同的HTML结构。数据层则存储域名状态、爬虫访问日志、内容映射关系与任务队列。
在源码实现中,调度层常以PHP或Python编写,配合Redis实现高速队列。一个成熟的蜘蛛池源码不会将所有域名同时激活,而是采用轮询与权重衰减策略。例如,新加入的域名权重较低,访问频率受限;历史抓取频次高、返回状态码稳定的域名获得更高调度优先级。这种设计直接决定了蜘蛛池源码的抓取效率与存活周期。
二、核心模块拆解
2.1 域名池管理模块
域名池管理模块负责域名的增删改查、状态标记与分组。源码中通常包含domain表,字段涵盖域名、绑定IP、DNS状态、最后抓取时间、抓取次数、是否被封禁等。高级蜘蛛池源码会引入域名健康度评分,根据最近7天的百度蜘蛛访问次数、返回200状态码比例、页面平均大小等指标动态计算。评分低于阈值的域名自动进入冷却队列,不再参与调度。
2.2 爬虫识别与分流模块
该模块通过User-Agent、IP反查、访问频率等特征识别搜索引擎爬虫。源码中一般维护一个爬虫UA白名单,同时结合反向DNS验证,避免伪装爬虫消耗域名资源。识别为真实爬虫后,分流模块根据当前域名池的负载情况,将请求路由到内容生成器或静态缓存。非爬虫访问则返回预设的普通页面或直接跳转,以降低服务器压力。
2.3 内容调度与模板引擎
蜘蛛池源码的内容层通常不存储大量原创文章,而是采用模板片段组合、同义词替换、段落随机排序等方式生成差异化页面。模板引擎支持变量插入,例如将目标关键词、长尾词、随机句子填入预设HTML骨架。为避免搜索引擎判定为低质采集,源码中会设置内容相似度阈值,当两个域名返回的页面相似度超过设定值时,触发重新生成或切换模板。
2.4 日志与统计模块
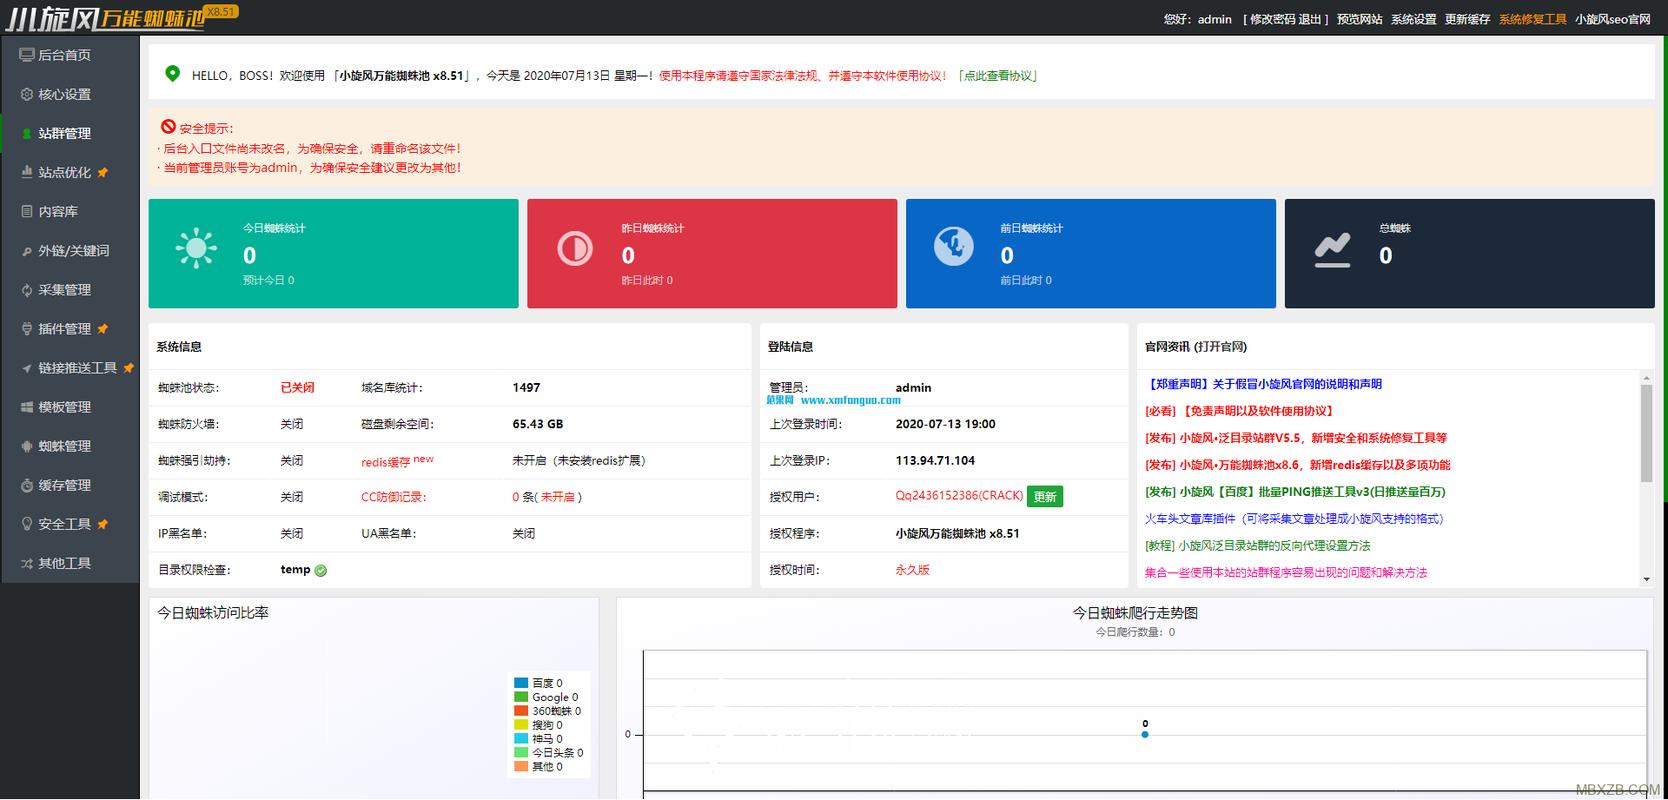
日志模块记录每次爬虫访问的域名、时间、UA、IP、返回状态码与响应时间。统计模块基于日志生成报表,包括各域名被抓取频次、抓取深度、目标URL被索引情况。实战中,运维人员通过分析日志发现哪些域名已被降权,哪些模板更受爬虫欢迎,从而调整蜘蛛池源码的调度参数。
三、数据库结构关键表设计
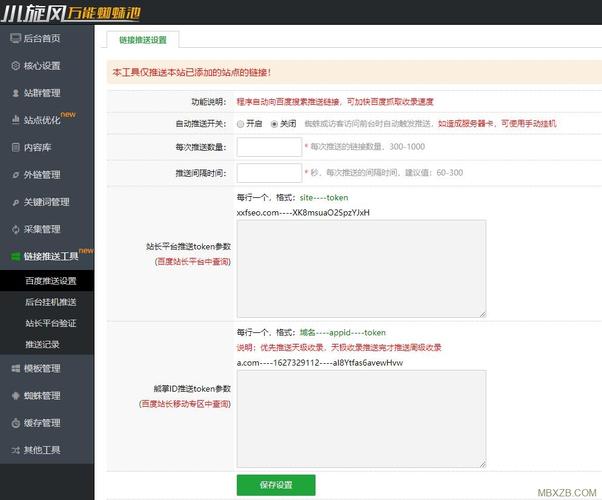
以下为蜘蛛池源码中常见的核心表结构示例,采用MySQL与Redis混合存储。MySQL负责持久化域名与内容映射,Redis负责实时队列与计数器。
表一:spider_domain。字段包括id、domain、ip、status、score、last_crawl_time、crawl_count、ban_flag。status取值0表示未激活,1表示正常,2表示冷却,3表示封禁。score为浮点数,范围0到100。
表二:spider_content。字段包括id、domain_id、template_id、keyword、content_hash、create_time。content_hash用于去重,避免同一域名重复输出相同内容。
表三:spider_log。字段包括id、domain_id、spider_ip、user_agent、request_uri、status_code、response_time、create_time。该表按天分区,便于快速清理历史数据。
Redis中通常使用有序集合存储域名优先级,使用列表存储待抓取URL队列,使用哈希存储域名实时计数器。蜘蛛池源码通过Lua脚本保证原子性操作,例如同时判断域名是否冷却并扣减配额。
四、实战部署要点
4.1 服务器与DNS配置
蜘蛛池源码部署需要多IP环境。建议使用多台VPS或独立服务器,每台绑定多个IP,域名通过泛解析指向不同IP。DNS层面设置较低的TTL,便于快速切换。Nginx配置中需关闭对爬虫的限速,同时设置合理的keepalive_timeout与client_header_timeout。若使用CDN,需确保CDN不缓存动态调度结果,否则蜘蛛池源码的调度逻辑会失效。
4.2 性能调优
蜘蛛池源码在高并发爬虫访问下,瓶颈通常出现在数据库写入与模板渲染。优化手段包括:将日志写入改为异步队列,使用Redis批量入库;模板渲染结果缓存到内存或SSD,减少重复计算;对MySQL表进行分表分库,按域名ID哈希。PHP-FPM或Gunicorn的进程数需根据CPU核心数与内存调整,避免过多进程导致上下文切换开销。
4.3 安全与反检测
蜘蛛池源码本身不违法,但使用方式决定风险。部署时应避免所有域名返回完全相同的页面标题与描述。建议为每个域名配置独立的robots.txt与sitemap,虽然蜘蛛池不依赖sitemap,但缺失这些文件容易引起搜索引擎警觉。同时,控制单个域名的日抓取频次,模拟自然站点的更新节奏。源码中可加入随机延迟,在爬虫请求到达后延迟50至200毫秒再返回内容。
五、风险控制与合规边界
搜索引擎对蜘蛛池的识别能力持续提升。常见打击手段包括:分析域名注册信息聚类、检测页面模板指纹、监控跨域名链接拓扑。因此,蜘蛛池源码的运维者需要定期更换域名池、更新模板库、调整调度策略。从合规角度看,蜘蛛池技术若用于攻击竞争对手、制造垃圾索引或传播恶意内容,将违反搜索引擎服务条款甚至相关法律法规。本文仅从技术架构角度解析蜘蛛池源码,不鼓励任何违规操作。
对于希望提升正规站点收录效率的开发者,可借鉴蜘蛛池源码中的调度思想,例如建立站内URL优先级队列、根据爬虫日志动态调整内链结构、使用CDN边缘节点返回差异化缓存。这些思路在合法合规前提下同样有效。
六、总结
蜘蛛池源码是一套融合了爬虫识别、任务调度、内容生成与数据统计的复合系统。其技术难点不在于单点功能,而在于各模块之间的协同与实时决策。理解蜘蛛池源码的架构,有助于开发者构建更高效的爬虫引导系统,同时也能帮助安全人员识别此类系统的行为特征。无论用于何种目的,控制抓取频率、保持内容差异、监控域名健康度都是长期稳定运行的关键。
亮点功能
- ✦ 蜘蛛池变现新路径:黑帽SEO操盘手月入百万的灰色产业链调查
- ✦ 蜘蛛池变现新路径:黑帽SEO操盘手月入百万的灰色产业链调查
- ✦ 蜘蛛池变现新路径:黑帽SEO操盘手月入百万的灰色产业链调查