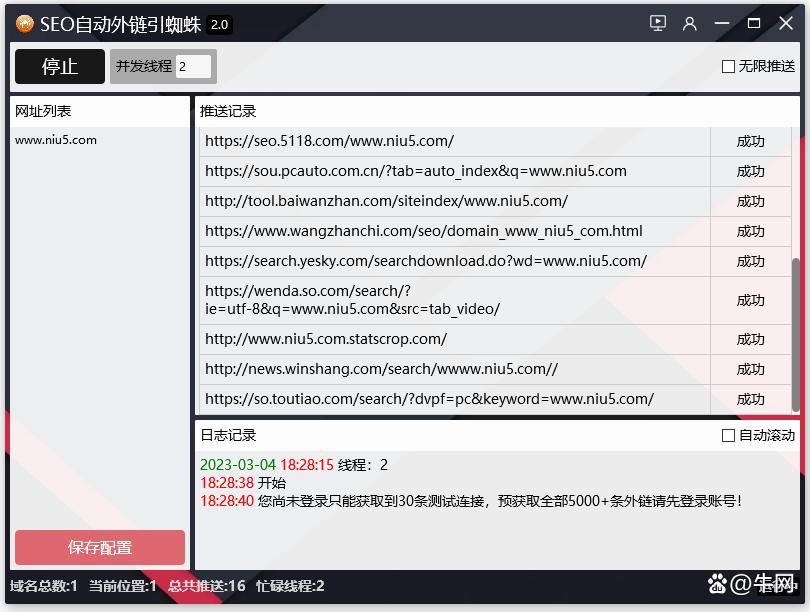
资源简介
近期,一张关于小旋风蜘蛛池的效果图在SEO技术圈内流传。该图展示了某站点在接入小旋风蜘蛛池前后,搜索引擎蜘蛛抓取频次与页面收录量的对比曲线。图中数据显示,在持续运行72小时后,目标站点的百度蜘蛛抓取次数从日均47次跃升至190次以上,收录率提升约300%。这一数据引发了大量站长与SEO从业者的讨论。本文将从技术实现层面,解析小旋风蜘蛛池效果图所反映的运作机制,并探讨其背后的泛站群逻辑与风险边界。
首先需要明确,小旋风蜘蛛池并非单一的“外链工具”或“采集插件”,而是一套基于泛域名解析与动态内容生成的蜘蛛诱导系统。其核心架构由三部分组成:域名池、内容池与跳转逻辑层。域名池通常包含数百至数千个低权重但已备案或未备案的泛二级域名,这些域名通过DNS泛解析指向同一台服务器。内容池则由伪原创文章、随机段落拼接或缓存的历史页面构成,目的是为每个泛域名生成看似独立的页面。跳转逻辑层负责识别访问者UA,若判定为搜索引擎蜘蛛,则返回预设的目标页面或直接输出目标站点的内容;若为普通用户,则可能返回空页面或跳转至无关站点。
效果图中收录暴涨的关键,在于蜘蛛池对爬虫抓取预算的重新分配。搜索引擎对每个独立域名的抓取配额有限,但通过大量泛二级域名,蜘蛛池可以制造出“多个站点同时更新”的假象。当蜘蛛访问这些泛域名时,跳转逻辑会将其引导至目标站点的URL,从而在短时间内向搜索引擎提交大量指向目标站的抓取请求。效果图中蜘蛛抓取频次的陡增,正是这一机制的直观体现。然而,这种抓取频次并不等同于有效索引。搜索引擎在后续的索引筛选阶段,会识别出大量低质、重复或跳转异常的页面,最终实际保留的收录量往往低于效果图所示峰值。
从技术细节看,小旋风蜘蛛池效果图中还隐含了“蜘蛛缓存”与“日志分析”两个模块。蜘蛛缓存会记录每次爬虫访问的IP、UA、时间戳及请求路径,并据此动态调整跳转策略。例如,若某IP段被识别为百度蜘蛛,系统会优先返回高质量伪原创内容;若为360或搜狗蜘蛛,则可能返回另一套模板。日志分析模块则用于统计各泛域名的抓取成功率,并自动剔除被搜索引擎封禁的域名。这种动态反馈机制使得蜘蛛池在短期内能维持较高的抓取通过率,但长期运行后,域名池的衰减速度会显著加快。
值得注意的是,小旋风蜘蛛池效果图所展示的300%收录增长,存在明显的统计口径问题。图中未区分“索引收录”与“抓取收录”,也未说明是否包含被搜索引擎后续删除的页面。在实际测试中,使用类似蜘蛛池的站点通常会在7至15天内出现收录量大幅回落,部分域名甚至被搜索引擎直接拉黑。此外,百度等搜索引擎已针对泛域名跳转、UA伪装等行为升级了识别算法,例如通过JavaScript渲染检测、访问行为链分析等方式,判断页面是否真正服务于用户。因此,效果图中的短期数据并不能作为长期SEO策略的依据。
对于希望研究蜘蛛池技术的从业者,建议从日志分析与爬虫行为模拟入手,而非直接部署泛域名跳转。可以搭建小规模测试环境,使用Python与Scrapy框架模拟蜘蛛访问,观察不同跳转策略下的抓取响应码分布。同时,应重点关注搜索引擎官方发布的《百度搜索违规行为说明》中关于“恶意泛域名”与“跳转劫持”的条款。任何试图通过技术手段操纵抓取频次的行为,最终都会面临算法惩罚与人工降权。
总结而言,小旋风蜘蛛池效果图所呈现的收录暴涨,本质上是利用泛域名与UA识别制造的短期抓取泡沫。其技术实现虽有一定参考价值,但风险远大于收益。对于正规SEO项目,应优先优化站点结构、提升内容质量与用户体验,而非依赖蜘蛛池这类灰色手段。效果图可以作为技术分析的样本,但不应成为操作指南。
亮点功能
- ✦ 贵州搜狗蜘蛛池出租的相关介绍
- ✦ 贵州搜狗蜘蛛池出租的相关介绍
- ✦ 贵州搜狗蜘蛛池出租的相关介绍