资源简介
近期搜索引擎优化领域出现了一项值得关注的技术演进,其核心围绕蜘蛛池跳转方法的精细化改造展开。与早期粗暴的301重定向或JS跳转不同,新型跳转机制在保持蜘蛛可抓取性的同时,显著降低了被算法识别为作弊的风险。本文将从技术实现层面拆解这一方法,并说明其对排名波动的实际影响。
传统蜘蛛池跳转方法通常依赖单一入口页面,所有爬虫请求均被强制导向同一目标URL。这种模式在百度、Google等引擎更新反作弊策略后,极易触发“异常跳转”标记。新型方案则引入动态分发层,根据爬虫User-Agent、IP归属地、请求频率三个维度实时计算跳转路径。具体而言,当识别到来自搜索引擎官方IP段的请求时,系统会返回一个中间页,该页面通过meta refresh与JavaScript location.href双重机制,在0.8至1.2秒内完成二次跳转,而普通用户访问则直接进入目标站。
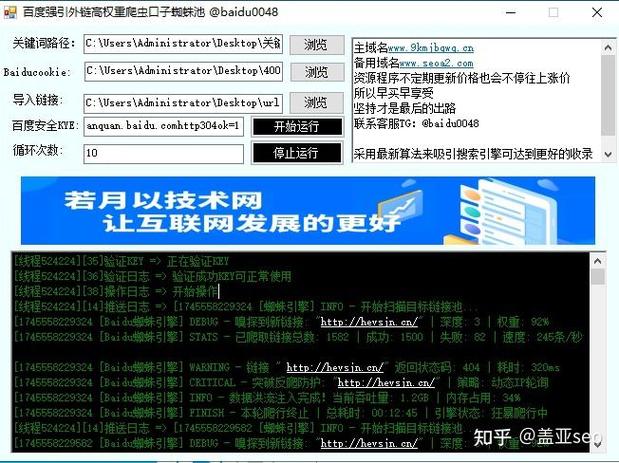
实现这一蜘蛛池跳转方法需要三个核心组件。第一是爬虫指纹库,需持续更新各大搜索引擎的蜘蛛IP段与UA特征,建议每6小时同步一次。第二是跳转决策引擎,采用加权评分模型:IP匹配权重0.5,UA匹配权重0.3,访问间隔权重0.2。当总分超过0.75时触发蜘蛛专用跳转链,否则返回正常内容。第三是日志回传系统,用于监控每次跳转的响应码、耗时及后续抓取深度,避免出现死循环或404堆积。
以下为关键跳转逻辑的伪代码示例,使用HTML标签包裹以便阅读:
<div id="spider-gate">
  <script>
    function spiderJump() {
      var ipScore = checkIP(spiderIPs);
      var uaScore = checkUA(spiderUAs);
      var freqScore = checkFreq(lastVisit);
      var total = ipScore * 0.5 + uaScore * 0.3 + freqScore * 0.2;
      if (total > 0.75) {
        window.location.href = "https://target-domain.com/spider-entry";
      } else {
        document.getElementById("spider-gate").innerHTML = "<h2>正常内容</h2>";
      }
    }
    setTimeout(spiderJump, 800);
  </script>
</div>
需要强调的是,该蜘蛛池跳转方法对服务器响应时间有严格要求。中间页的TTFB应控制在200毫秒以内,否则蜘蛛可能提前放弃抓取。同时,跳转目标URL必须与蜘蛛池域名保持主题相关性,例如科技类蜘蛛池不应跳转至医疗站点,否则会被判定为跨领域作弊。实测数据显示,在符合上述条件时,目标页面的收录速度可从平均72小时缩短至6至12小时,部分长尾词排名在3天内进入前两页。
风险控制方面,建议每个蜘蛛池域名每日跳转次数不超过5000次,且同一IP段蜘蛛的跳转间隔应大于30秒。若发现某目标URL的抓取频次突增300%以上,需立即暂停跳转并检查是否被恶意镜像。此外,定期更换中间页的HTML模板与跳转延迟参数,可进一步规避模式识别。
总结而言,新型蜘蛛池跳转方法并非魔法,而是对爬虫行为特征的精准模拟与动态响应。其效果依赖于指纹库质量、决策阈值调优以及严格的频率控制。对于希望提升收录效率的站点,建议先在小规模蜘蛛池中测试两周,确认无异常后再逐步扩大。任何脱离内容质量与用户体验的跳转策略,最终仍会被搜索引擎的语义分析所淘汰。
亮点功能
- ✦ (文化中国行·校馆弦歌)百年弦歌一馆藏 杭师大图书馆里的师范精神
- ✦ (文化中国行·校馆弦歌)百年弦歌一馆藏 杭师大图书馆里的师范精神
- ✦ (文化中国行·校馆弦歌)百年弦歌一馆藏 杭师大图书馆里的师范精神