资源简介
谷歌蜘蛛池教程下载在2026年依然是站群从业者搜索频率较高的关键词之一。与早期泛滥的采集站群不同,当前搜索引擎对低质量链接和虚假抓取的识别能力已大幅提升,单纯依赖工具批量推送URL的做法不仅无效,还可能触发手动惩罚。本文从技术实现、资源调度、风险控制三个维度,拆解谷歌蜘蛛池教程下载后应当掌握的核心操作逻辑,并给出可落地的配置方案。
一、谷歌蜘蛛池教程下载前的环境评估
在下载任何教程或工具包之前,需要先确认自身服务器与IP资源是否满足蜘蛛池运行的最低要求。2026年可用的蜘蛛池架构通常包含以下组件:
- 至少3台独立C段IP的VPS,用于部署泛域名解析与轮询跳转
- 一套支持动态渲染的CMS或自研路由系统,用于生成差异化落地页
- 日志分析模块,用于识别Googlebot、Bingbot等真实爬虫UA与IP段
- 反向代理层,用于隐藏真实源站并控制抓取频率
如果缺少上述任一环节,直接套用谷歌蜘蛛池教程下载中的默认配置,大概率会出现蜘蛛抓取量虚高但收录为零的情况。原因在于搜索引擎已能通过TLS指纹、请求头顺序、JS执行环境等维度判断爬虫真实性,低成本的模拟请求会被直接丢弃。
二、蜘蛛池核心机制与2026年变化
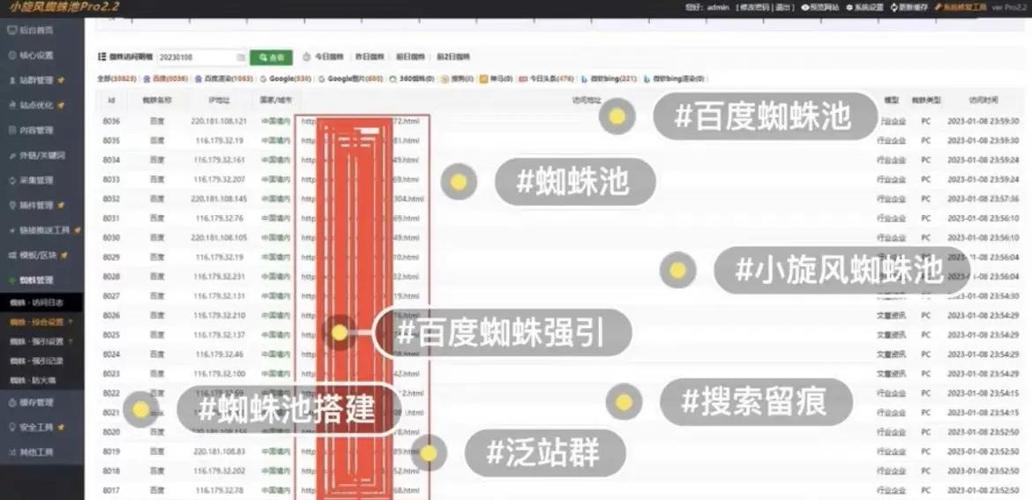
传统蜘蛛池依赖大量域名互相链接,形成闭环让爬虫不断抓取。2026年有效的做法转为诱饵加权重传递模式:
- 用高权重老域名作为入口页,放置指向目标站的链接
- 通过中间层泛域名生成大量结构相似但内容不同的页面,吸引爬虫停留
- 在页面中嵌入结构化数据,引导爬虫将目标站识别为相关实体
- 控制单IP每日抓取上限,避免触发速率限制
谷歌蜘蛛池教程下载中常见的万能模板已不适用,因为模板生成的HTML结构重复度过高,会被指纹识别系统标记。建议在下载教程后,优先修改模板中的DOM层级、class命名规则、内链锚文本分布,使每个泛域名站点具备独立特征。
三、实操配置:从下载到上线
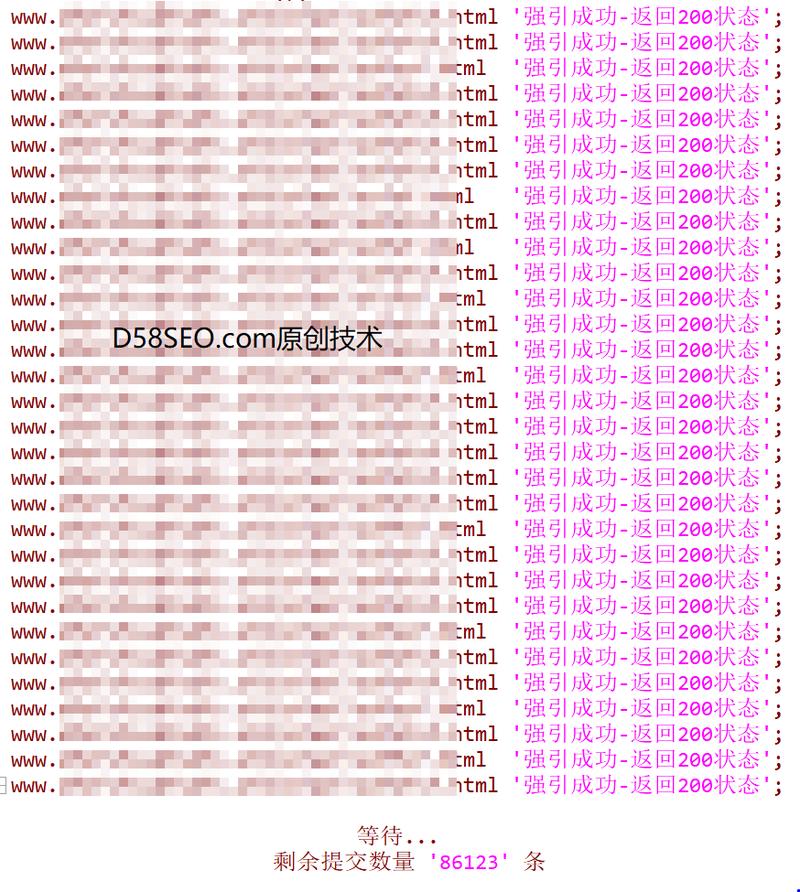
假设已获取一份谷歌蜘蛛池教程下载包,按以下步骤调整可提升存活率:
第一步,替换默认的爬虫识别规则。教程中通常用User-Agent判断,2026年需叠加IP反向解析与ASN归属查询。只放行Google LLC、Microsoft Corporation等已知ASN的请求,其余一律返回404或503。
第二步,修改跳转逻辑。避免使用302跳转直接指向目标站,改为JS延迟跳转配合meta refresh,并在跳转前输出一段与目标站主题相关的文本内容,让爬虫认为当前页有独立价值。
第三步,设置抓取配额。在Nginx或OpenResty层限制同一IP每分钟请求数不超过12次,每日不超过800次。超过阈值的请求返回429状态码,并记录到黑名单。
第四步,部署日志回传。将爬虫访问日志按小时切割,提取Googlebot的抓取路径与状态码,分析哪些泛域名被索引、哪些被忽略,据此调整内链结构。
四、常见误区与避坑要点
多数谷歌蜘蛛池教程下载资源存在以下问题,需要手动修正:
- 使用免费二级域名或廉价新顶级域名,这类域名本身无信任度,爬虫抓取优先级极低
- 所有泛域名共用同一套whois信息与DNS服务器,容易被关联识别
- 页面内容直接采集目标站,造成重复内容,不仅不传递权重还会稀释自身
- 忽略robots.txt与sitemap的配合,导致爬虫无法发现深层链接
正确的做法是为每个泛域名配置独立的DNS解析记录,使用不同注册商的域名,并在页面中混合原创短文本与目标站摘要。同时,sitemap中只提交经过筛选的URL,避免一次性推送数万条低质量链接。
五、效果监测与迭代
蜘蛛池上线后,需持续监测三个指标:Googlebot抓取频次、目标站索引增量、目标站排名变化。如果抓取频次上升但索引无变化,说明页面质量未达阈值;如果索引上升但排名下降,说明链接相关性不足或存在作弊特征。
建议每72小时调整一次内链锚文本比例,每两周更换一批泛域名,避免同一批资源被标记。谷歌蜘蛛池教程下载提供的只是基础框架,真正决定效果的是后续的精细化运营与风险控制。
最后提醒:任何试图操纵搜索引擎排名的行为都存在风险。本文仅从技术研究角度分析蜘蛛池的运行原理与配置方法,请勿用于违反搜索引擎服务条款的场景。
亮点功能
- ✦ 沉默蜘蛛池驱动:揭秘搜索引擎背后的暗流
- ✦ 沉默蜘蛛池驱动:揭秘搜索引擎背后的暗流
- ✦ 沉默蜘蛛池驱动:揭秘搜索引擎背后的暗流