资源简介
蜘蛛池战群源码是一套面向搜索引擎蜘蛛行为模拟与流量分发的分布式系统实现。其核心目标在于通过多节点协同、请求调度与内容伪装,将爬虫流量引导至目标站点,从而提升收录效率与排名权重。本文从架构设计、核心模块、部署流程与优化策略四个维度展开,不涉及任何具体业务场景的合规性讨论,仅做技术层面的源码级剖析。
一、整体架构设计
蜘蛛池战群源码通常采用主从加对等混合拓扑。主控节点负责全局策略下发、任务队列管理与数据聚合;从节点执行具体的蜘蛛诱导、页面渲染与链接跳转。节点之间通过轻量级消息总线通信,常见实现为Redis Pub/Sub或ZeroMQ。源码中一般包含以下目录结构:
/spider_pool
  /core        调度引擎与状态机
  /node        节点代理与心跳模块
  /render      动态页面生成与UA伪装
  /link        链接工厂与跳转链
  /data        日志、统计与持久化
  /config      环境配置与密钥管理
该架构的关键在于去中心化决策:每个从节点可根据本地负载与目标站点反爬强度动态调整请求频率,主控仅做粗粒度协调。源码中常通过一致性哈希将目标域名映射到固定节点组,减少跨节点通信开销。
二、核心模块源码解析
2.1 调度引擎
调度引擎基于时间轮与优先级队列实现。源码中常见类SpiderScheduler,内部维护pendingQueue与runningSet。每个任务包含目标URL、期望蜘蛛类型(Baiduspider、Googlebot等)、最大跳转深度、存活时间。调度算法采用加权轮询,权重由节点历史成功率与响应延迟计算得出。关键代码片段如下:
def dispatch(self, task):
    node = self.select_node(task.domain)
    if node.load < node.capacity:
        node.push(task)
        self.running_set.add(task.id)
    else:
        self.pending_queue.put(task, priority=task.urgency)
为避免惊群效应,源码中通常加入随机退避与令牌桶限流。令牌桶的填充速率与目标站点的robots.txt抓取延迟建议值挂钩。
2.2 节点代理与心跳
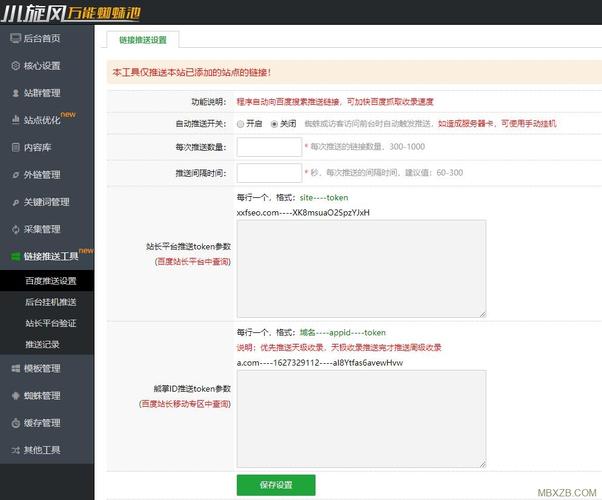
每个从节点运行一个NodeAgent进程,负责注册、心跳上报与任务拉取。心跳包中包含CPU、内存、当前并发数、最近一分钟成功率。主控根据心跳数据动态调整节点权重。源码中心跳间隔一般为5秒,超时3次即标记为不可用。节点代理还实现了优雅退出:收到停止信号后,先完成正在执行的任务,再从注册中心注销。
2.3 页面渲染与UA伪装
蜘蛛池战群源码的渲染模块必须能够生成对搜索引擎蜘蛛友好的HTML,同时对人眼或普通浏览器返回不同内容。源码中常见双缓冲策略:对请求头中User-Agent包含蜘蛛标识的请求,返回预置的静态化页面或伪原创内容;对普通UA则返回跳转脚本或空白页。UA伪装库通常维护一个可配置的蜘蛛UA列表,并支持正则匹配。渲染引擎可选用无头浏览器或轻量模板引擎,前者资源消耗大但伪装度高,后者适合高并发场景。
2.4 链接工厂与跳转链
链接工厂负责生成蜘蛛可爬取的链接网络。源码中通过有向图管理链接关系,每个节点代表一个页面,边代表超链接。为避免蜘蛛陷入死循环,图中设置最大出度与最大深度。跳转链通常采用302临时重定向或JavaScript跳转,源码中会记录每个跳转的命中次数与蜘蛛通过率,并据此动态修剪低效链接。
三、实战部署流程
部署蜘蛛池战群源码需要准备多台具有独立IP的服务器,建议至少3个节点起步。步骤如下:
- 环境初始化:安装Python 3.8以上、Redis 5.0以上、Nginx作为反向代理。关闭SELinux与防火墙对内部端口的限制。
- 配置主控节点:修改
config/master.yaml,设置监听端口、Redis连接串、节点认证密钥。启动master.py。 - 配置从节点:在每个从节点上修改
config/node.yaml,填入主控地址、本机公网IP、最大并发数。启动node_agent.py。 - 导入目标域名与关键词:通过主控提供的HTTP API批量导入,源码中通常有
/api/import接口,接受JSON数组。 - 验证蜘蛛模拟:使用
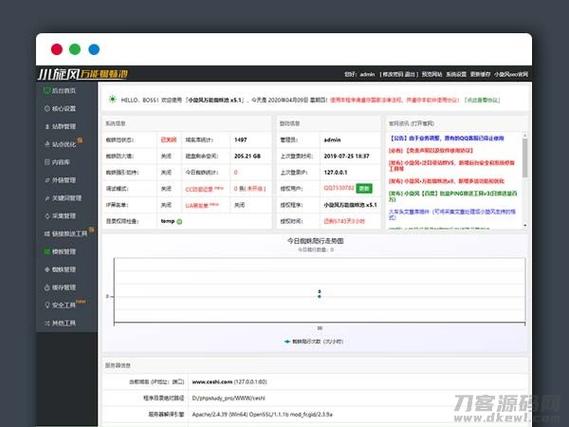
curl -A "Baiduspider"请求节点上的测试页面,检查返回内容是否与普通UA不同。 - 监控与日志:主控面板展示各节点QPS、成功率、蜘蛛占比。日志按天切割,保留7天。
部署过程中常见问题包括:节点时间不同步导致令牌桶失效,需配置NTP;Redis连接数不足,需调整maxclients;Nginx未传递真实UA,需在proxy_set_header中保留User-Agent。
四、性能优化与反反爬策略
蜘蛛池战群源码的性能瓶颈通常出现在DNS解析与TCP连接建立阶段。优化手段包括:使用本地DNS缓存、开启HTTP长连接、对同一目标域名复用连接池。源码中可引入aiohttp或httpx异步客户端,将单节点并发提升至2000以上。
反反爬方面,源码需实现以下机制:
- 请求间隔随机化:在基础间隔上叠加高斯噪声,避免固定频率。
- 蜘蛛IP反向验证:对声称是蜘蛛的请求,通过DNS反查确认其来源IP属于搜索引擎官方网段。
- 内容指纹规避:每次渲染时对HTML标签顺序、注释、空白字符做微小扰动,防止被识别为模板化页面。
- 分布式限速:主控根据目标站点的响应码分布动态调整全局速率,遇到403或429时自动降速并切换节点。
此外,源码中应包含熔断机制:当某节点连续失败超过阈值,自动隔离该节点并告警。熔断恢复采用半开模式,试探性放行少量请求。
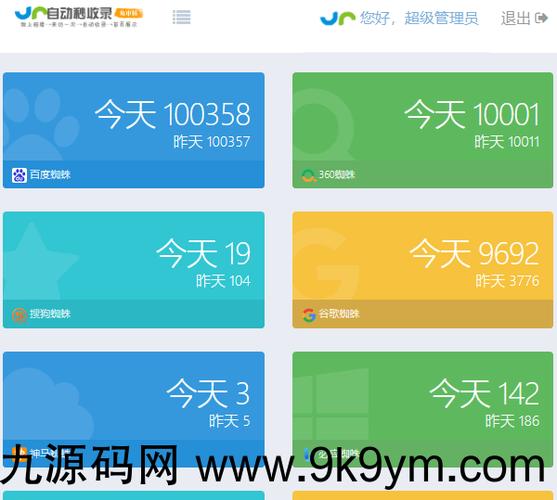
五、源码二次开发建议
若需基于现有蜘蛛池战群源码进行二次开发,建议优先扩展以下方向:第一,增加对HTTP/2与HTTP/3的支持,提升蜘蛛抓取效率;第二,引入机器学习模型对蜘蛛行为进行聚类,自动识别新型爬虫;第三,将状态存储从Redis迁移至etcd,提高一致性;第四,增加WebSocket实时推送,替代轮询获取节点状态。开发过程中需保持接口向后兼容,避免破坏现有节点通信协议。
最后,任何技术方案都应在法律与目标网站服务条款允许的范围内使用。蜘蛛池战群源码本身是中性的分布式调度框架,其价值取决于使用者的目的与方式。
亮点功能
- ✦ 搜狗泛收录蜘蛛池租用:助力网站快速提升收录效率
- ✦ 搜狗泛收录蜘蛛池租用:助力网站快速提升收录效率
- ✦ 搜狗泛收录蜘蛛池租用:助力网站快速提升收录效率