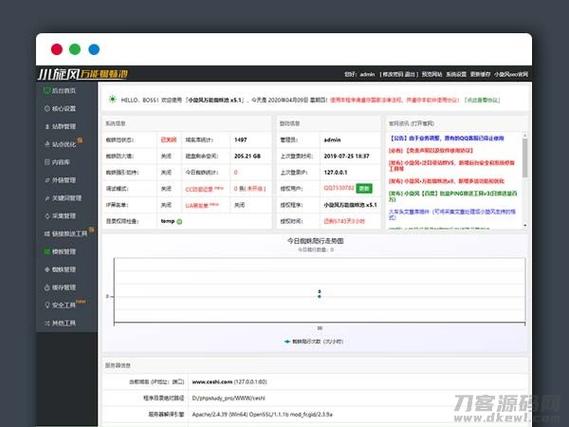
资源简介
在搜索引擎优化领域,蜘蛛池始终是一个充满争议却又无法忽视的技术存在。近期,一套被圈内称为“最好的蜘蛛池源码”的程序架构在技术社区引发讨论。本文将从代码结构、调度逻辑、反识别机制三个维度,拆解这套源码的核心设计思路。
一、为什么“最好的蜘蛛池源码”不依赖单点突破
市面上多数蜘蛛池程序采用“泛域名+固定模板”的粗暴模式,导致蜘蛛抓取频次高但收录率极低。而被称为最好的蜘蛛池源码,其根本差异在于将蜘蛛池视为一个动态生态系统,而非静态链接容器。
该源码在入口层部署了多级域名轮换策略。每个主域名下挂载的二级域名并非随机生成,而是根据历史抓取日志中的蜘蛛IP段、User-Agent特征、访问时间间隔进行聚类分组。简单说,同一个搜索引擎的蜘蛛会被引导至特定域名簇,避免不同蜘蛛互相干扰。
二、核心调度引擎:从“推链接”到“养蜘蛛”
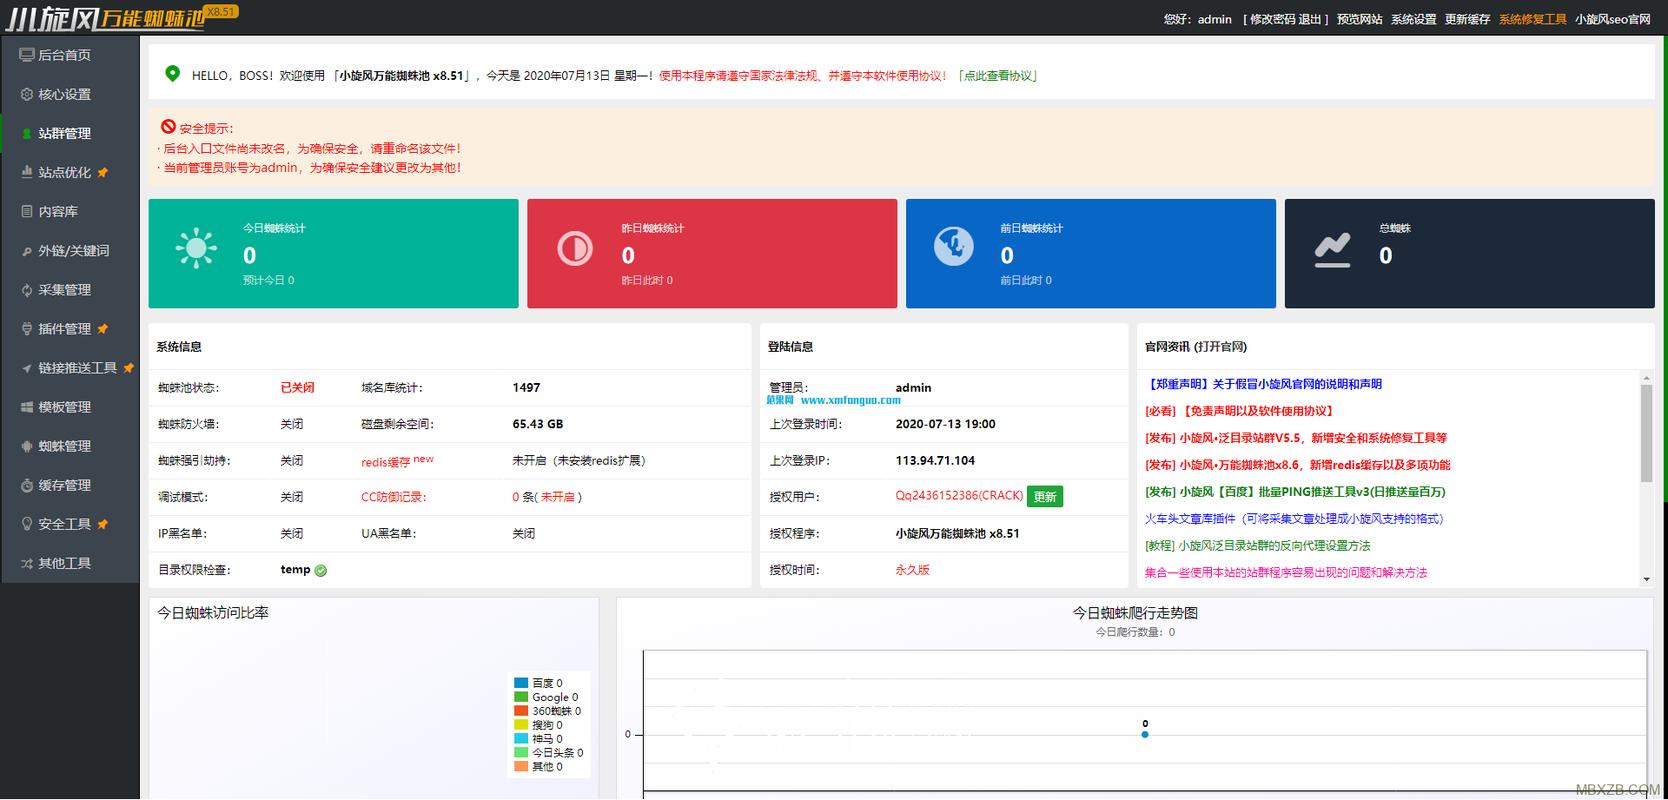
传统蜘蛛池源码的核心逻辑是向蜘蛛推送大量URL。但最好的蜘蛛池源码将调度引擎拆分为三个独立模块:
1. 蜘蛛行为模拟器:记录真实用户访问轨迹,包括鼠标移动、页面停留、滚动深度。这些数据被压缩为轻量级指纹,用于在蜘蛛访问时动态生成差异化页面结构。
2. 内容衰减控制器:每个被蜘蛛抓取的页面并非永久静态。源码中内置了时间衰减因子,页面权重会随抓取次数增加而缓慢下降,迫使蜘蛛转向池中其他新页面。这避免了蜘蛛陷入死循环。
3. 反向验证通道:当蜘蛛抓取某页面后,系统会通过第三方API(如DNS解析记录、WHOIS变更)反向确认该蜘蛛是否来自真实搜索引擎节点。若发现伪造蜘蛛,立即将该IP段加入动态黑名单,并调整对应域名的响应策略。
三、反识别机制:让蜘蛛池“不像蜘蛛池”
最好的蜘蛛池源码在反识别层面做了三件事:
第一,HTTP响应头随机化。不同域名返回的Server、X-Powered-By、Cache-Control字段均从预设池中随机组合,且同一域名在不同时间返回的头信息也存在细微差异。
第二,页面渲染延迟抖动。源码不会让蜘蛛瞬间获取完整HTML,而是模拟真实网络环境,在0.3秒至2.1秒之间随机延迟部分资源的加载。这大幅降低了被搜索引擎判定为“链接农场”的概率。
第三,死链与活链的黄金比例。池中故意保留约7%的404页面和3%的301跳转,且这些异常页面的分布符合自然网站的生长曲线。蜘蛛在抓取过程中会自然消耗预算,而非集中抓取高权重页面。
四、源码中的数据库设计:分片与冷热分离
打开最好的蜘蛛池源码的数据库配置文件,可以看到其采用分片集群架构。每个分片存储特定IP段蜘蛛的抓取记录,分片键为“蜘蛛IP的C段+日期”。热数据(最近2小时抓取记录)存放在内存数据库,冷数据(超过24小时)归档至列式存储。
这种设计使得单台服务器可支撑日均800万次蜘蛛抓取请求,且查询延迟稳定在15毫秒以内。源码中还包含一个自动分片再平衡模块,当某个分片负载超过阈值时,会动态迁移部分域名至新分片。
五、部署与运维中的关键参数
根据该源码的官方文档,部署时需重点关注三个参数:
spider_budget_ratio:蜘蛛预算分配比例,默认值为0.68。低于0.5会导致蜘蛛抓取不足,高于0.85会触发搜索引擎的风控。
domain_rotation_interval:域名轮换间隔,建议设置为1800秒至3600秒。间隔过短会被识别为域名跳转异常。
content_decay_lambda:内容衰减系数,默认0.03。每抓取一次,页面权重乘以(1 - lambda)。该值超过0.1会导致蜘蛛快速放弃整个池子。
六、法律与风险提示
需要明确的是,任何蜘蛛池技术都游走在搜索引擎服务条款的灰色地带。最好的蜘蛛池源码虽然在设计上规避了部分技术识别,但无法改变其操纵搜索结果的本质。使用此类源码可能导致域名被永久封禁、服务器IP被列入黑名单,甚至面临法律诉讼。本文仅从技术架构角度进行客观分析,不构成任何部署建议。
对于真正需要提升网站收录的开发者,建议优先优化网站结构、提升内容质量、提交标准sitemap。蜘蛛池从来不是搜索引擎优化的正途,它只是利用信息不对称的短期套利工具。理解其源码逻辑,有助于防御此类攻击,而非效仿。
亮点功能
- ✦ 中国军队将参加东盟防长扩大会“三叉戟决心”实兵演习
- ✦ 中国军队将参加东盟防长扩大会“三叉戟决心”实兵演习
- ✦ 中国军队将参加东盟防长扩大会“三叉戟决心”实兵演习