资源简介
在信息爆炸的时代,新闻聚合平台面临的核心挑战在于如何高效、稳定地从海量互联网源中采集内容,并完成结构化处理与分发。传统单机爬虫受限于IP封锁、请求频率限制以及动态页面渲染等问题,难以支撑大规模、持续性的数据获取任务。Python蜘蛛池作为一种分布式爬虫调度架构,通过多节点协同与资源池化管理,为新闻聚合场景提供了可扩展的技术方案。
Python蜘蛛池的本质并非单一工具,而是一套基于Python生态构建的调度系统。其核心组件包括任务队列、代理IP池、用户代理池、Cookie池以及分布式爬虫节点。任务队列通常采用Redis或RabbitMQ实现,负责将待抓取的URL按优先级分发至各节点。代理IP池通过API接口动态获取并验证可用代理,配合请求重试机制,有效规避目标站点的反爬策略。用户代理池模拟不同浏览器与设备指纹,降低被识别为自动化脚本的概率。Cookie池则用于维持会话状态,适用于需要登录或频繁交互的新闻站点。
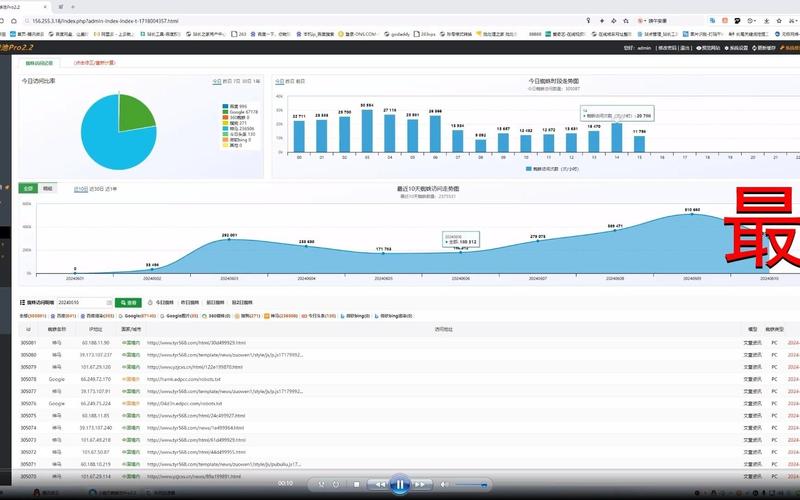
在新闻聚合场景中,蜘蛛池的调度策略需要针对内容时效性进行优化。例如,对高频更新的新闻首页采用短周期轮询,对已抓取的详情页设置较长的去重时间窗口。去重模块通常结合布隆过滤器与Redis集合,在内存占用与准确率之间取得平衡。抓取到的原始HTML经由解析器提取标题、正文、发布时间、作者与来源,再通过自然语言处理模块进行关键词抽取与分类打标。最终数据写入Elasticsearch或MySQL,供前端检索与推荐系统调用。
智能分发环节依赖蜘蛛池采集的元数据质量。通过分析新闻来源的更新频率、历史准确率以及内容相似度,系统可以为不同源分配动态权重。高权重源的内容优先进入审核队列,低权重源则进入抽样验证流程。此外,蜘蛛池支持增量抓取与断点续传,当某个节点因网络波动或代理失效而中断时,任务会自动重新入队并由其他节点接管,保证整体采集吞吐量不受单点故障影响。
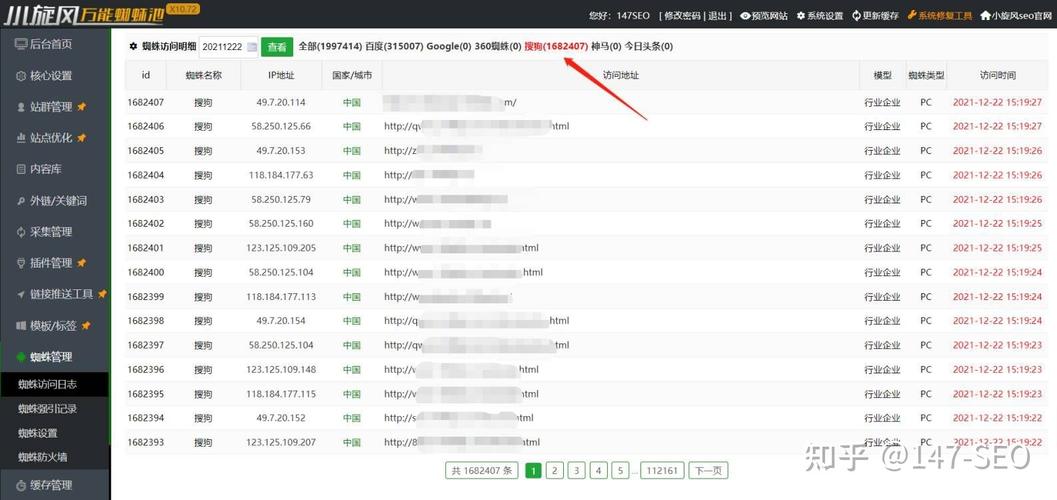
从工程实践角度看,构建一个可用的Python蜘蛛池需要关注以下技术细节。第一,代理IP的可用性检测必须异步执行,避免阻塞主抓取流程。第二,请求头中的Referer与Accept-Language字段应与目标站点保持语义一致。第三,针对JavaScript渲染的新闻页面,可集成Playwright或Splash作为渲染节点,但需控制并发数以防资源耗尽。第四,日志系统应记录每个URL的响应状态、耗时与代理使用情况,便于后续分析封禁规律。第五,遵守robots.txt协议并设置合理的抓取间隔,既是法律合规要求,也能降低对目标站点的负载压力。
当前,Python蜘蛛池技术正朝着容器化与Serverless方向演进。Kubernetes可以动态调度爬虫Pod,根据任务队列长度自动扩缩容。云函数则适合处理低频但突发的采集需求,按实际执行时间计费。与此同时,基于机器学习的反爬对抗策略逐渐成熟,例如使用强化学习动态调整请求间隔与代理切换频率。这些进展使得新闻聚合平台能够在保证数据新鲜度的同时,显著降低运维成本与法律风险。
综上所述,Python蜘蛛池为新闻聚合提供了一套兼顾效率与稳定性的采集基础设施。其价值不仅体现在突破反爬限制,更在于通过池化资源与智能调度,将零散的抓取能力转化为可观测、可控制的数据流水线。对于需要持续跟踪多源新闻的团队而言,合理设计蜘蛛池架构并持续优化调度参数,是提升内容竞争力的关键技术路径。
亮点功能
- ✦ SEO蜘蛛池实操指南:快速提升网站收录的终极教程
- ✦ SEO蜘蛛池实操指南:快速提升网站收录的终极教程
- ✦ SEO蜘蛛池实操指南:快速提升网站收录的终极教程