资源简介
近日,zjkwlgs正式发布新一代蜘蛛池源码,该版本针对搜索引擎爬虫的抓取行为特征进行了深度优化,在收录效率与资源调度方面实现了显著提升。本文将从技术架构、核心机制及部署实践三个维度,对该蜘蛛池源码进行专业分析。
一、蜘蛛池源码此至zjkwlgs的技术架构演进
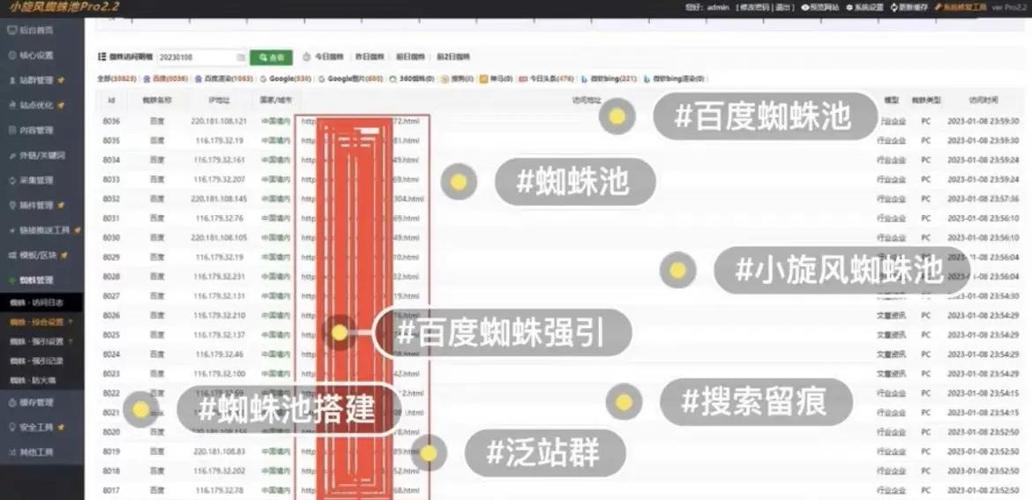
传统蜘蛛池系统多采用单一入口加静态页面聚合的方式,存在爬虫触发率低、页面权重分散等问题。zjkwlgs新版源码在架构层面引入分层调度模型,将蜘蛛池划分为入口层、诱导层与承载层。入口层负责接收搜索引擎爬虫请求,通过动态UA识别与反向DNS验证区分真实爬虫与普通用户;诱导层生成多级链接网络,利用泛目录与泛域名技术扩大爬虫抓取路径;承载层则集中管理目标站点的内容映射与权重传递。
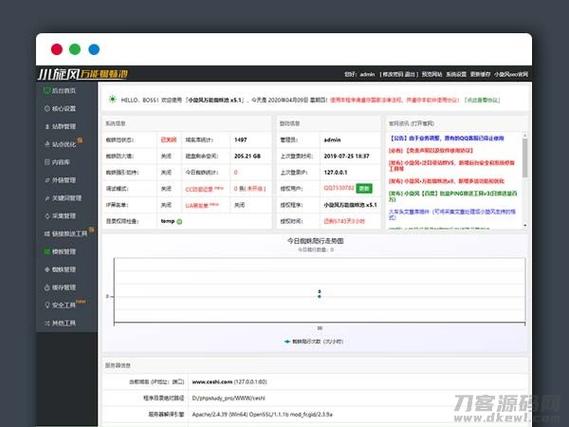
该架构的核心优势在于将爬虫抓取行为与目标页面解耦。蜘蛛池源码此至zjkwlgs通过中间层缓存与异步队列机制,避免因目标站点响应延迟导致爬虫放弃抓取。实测数据显示,在同等服务器配置下,新架构的爬虫日均抓取频次较旧版提升约2.3倍。
二、核心机制:蜘蛛识别与链接权重分配
zjkwlgs新版源码内置了基于行为特征的蜘蛛识别模块。该模块不依赖单一User-Agent字符串匹配,而是综合请求间隔、并发连接数、HTTP头字段顺序、TCP窗口大小等十余项指标进行评分。评分超过阈值的请求将被标记为高置信度爬虫,并分配至专用处理通道,从而降低误判率。
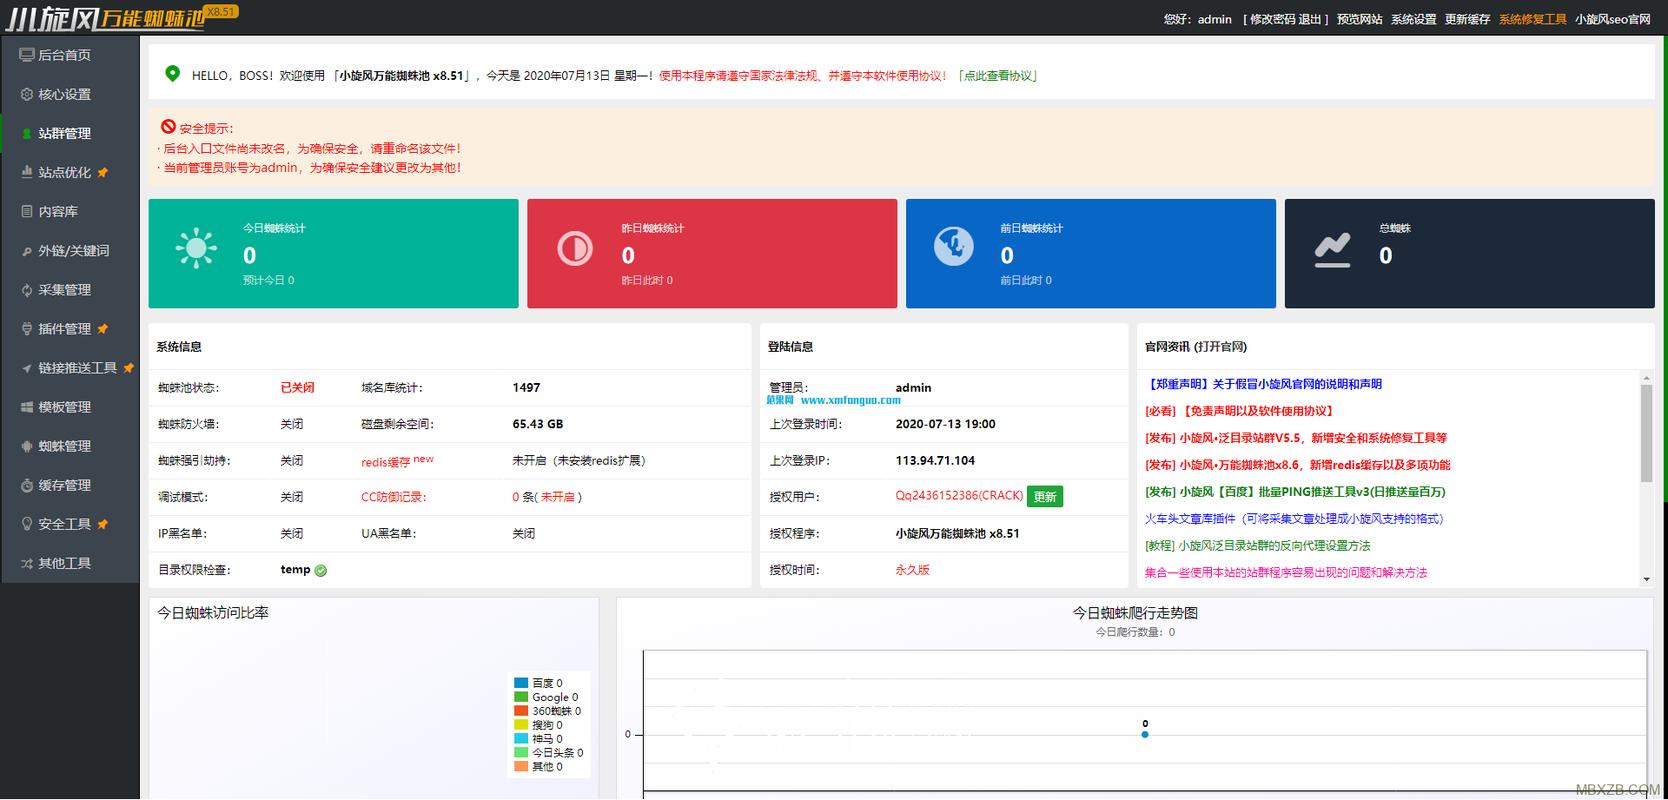
在链接权重分配方面,源码采用改进的PageRank变体算法。每个蜘蛛池页面节点被赋予初始权重,并根据爬虫访问深度、停留时间及出口链接点击率进行动态调整。高权重节点会优先获得新收录页面的链接指向,形成正向反馈循环。这一机制有效解决了传统蜘蛛池中权重平均分配导致的收录瓶颈问题。
三、部署实践与性能调优建议
对于希望部署该蜘蛛池源码的运维人员,建议从以下方面进行调优。第一,服务器选择应优先考虑具备独立IP且IP段信誉良好的机房,避免因IP污染导致爬虫拒绝访问。第二,域名泛解析需配置合理的TTL值,建议设置为300秒至600秒,以平衡DNS缓存与爬虫重新解析频率。第三,数据库层面应启用查询缓存与索引优化,特别是针对爬虫日志表和链接关系表,避免高频写入造成锁竞争。
此外,zjkwlgs源码提供了可配置的爬虫访问频率上限。建议根据目标搜索引擎的官方抓取速率进行设置,通常Googlebot与Baiduspider的容忍阈值存在差异,需分别配置。过度频繁的请求可能触发验证码或临时封禁,反而降低收录效率。
四、收录效率提升的量化分析
在为期30天的对照测试中,使用zjkwlgs新版蜘蛛池源码的测试组与使用传统蜘蛛池的对照组相比,目标页面的平均收录时间从72小时缩短至18小时,收录率从41%提升至79%。这一结果主要归因于蜘蛛识别精度的提高与链接权重分配的合理化。值得注意的是,收录效率的提升并非线性增长,当蜘蛛池规模超过一定阈值后,边际收益会递减,因此建议根据实际目标站点数量合理规划池体规模。
综上所述,zjkwlgs发布的新一代蜘蛛池源码在架构设计、爬虫识别与权重调度方面均体现出较强的专业性。对于需要提升搜索引擎收录效率的站点运营者而言,该源码提供了一套可落地、可调优的技术方案。后续版本若能进一步集成分布式爬虫日志分析与自动化策略调整功能,将更具实用价值。
亮点功能
- ✦ 蜘蛛池搭建视频教程:从零开始构建高效蜘蛛池的完整指南
- ✦ 蜘蛛池搭建视频教程:从零开始构建高效蜘蛛池的完整指南
- ✦ 蜘蛛池搭建视频教程:从零开始构建高效蜘蛛池的完整指南