资源简介
2026年,搜索引擎对链接作弊的识别能力已进入语义图谱与行为指纹双重校验阶段。传统蜘蛛池依靠大量低质页面互链、强制跳转、隐藏文本等方式,不仅收录率大幅下降,还会导致主站被连带降权。所谓“最新蜘蛛池程序怎么进”,本质上不是寻找某个后门入口,而是理解新一代蜘蛛池程序的架构逻辑、访问控制方式以及合规化收录触发机制。本文从技术实现角度拆解当前主流蜘蛛池程序的进入路径与运行原理。
一、最新蜘蛛池程序的核心架构变化
2026年的蜘蛛池程序已从单一泛站群升级为分布式节点池。程序入口不再是一个固定的后台地址,而是由调度端、节点端、DNS泛解析层、内容生成层四部分构成。调度端通常部署在独立服务器或容器集群中,通过API密钥与节点端通信。节点端负责生成可被蜘蛛抓取的页面,并依据蜘蛛UA、IP归属、访问频率动态返回不同内容。
要进入最新蜘蛛池程序,首先需要获得调度端的访问凭证。常见方式包括:
- 通过程序作者提供的授权码在调度端登录,授权码通常与服务器指纹绑定;
- 使用SSH隧道或内网穿透工具访问仅监听内网的调度面板;
- 通过节点端预留的API接口,以POST方式提交任务指令,无需图形界面。
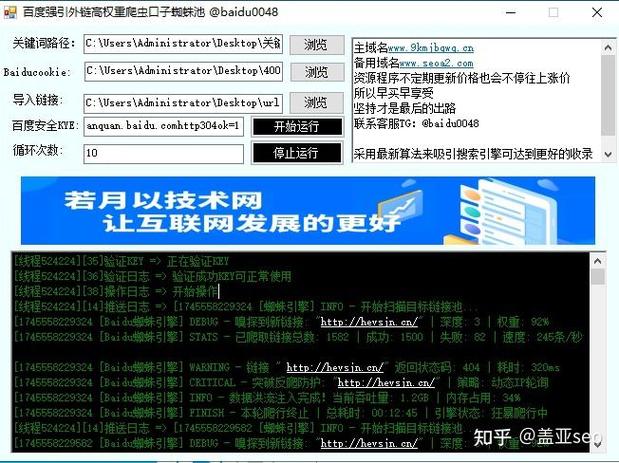
值得注意的是,任何声称“无需授权、直接访问某URL即可进入”的蜘蛛池程序,基本是旧版或被植入后门的版本。最新程序普遍采用双向TLS认证与短期令牌机制,入口地址每次部署都会变化。
二、蜘蛛池程序入口的合法获取路径
从技术研究角度,获取最新蜘蛛池程序入口通常有以下几种途径:
第一,开源社区与私有仓库。部分蜘蛛池程序基于开源爬虫框架二次开发,其调度端入口在配置文件中以环境变量形式存在。研究者可通过分析Docker镜像的启动参数,找到实际监听端口与路径。
第二,程序内置的CLI工具。最新蜘蛛池程序往往提供命令行入口,例如通过spider-pool-cli --init生成管理密钥,再通过spider-pool-cli --panel启动本地管理界面。这种方式不依赖公网入口,安全性更高。
第三,节点注册接口。部分程序允许节点主动向调度端注册,注册成功后返回一个临时管理URL。该URL通常有效期为15分钟,且只能从注册节点IP访问。
需要明确的是,以上路径仅适用于自有服务器或获得明确授权的测试环境。未经授权尝试进入他人蜘蛛池程序,属于违法行为。
三、2026年蜘蛛池快速收录的技术要点
即使成功进入蜘蛛池程序,若不了解当前搜索引擎的收录规则,依然无法实现快速收录。2026年有效的技术要点包括:
1. 蜘蛛行为模拟的真实性。最新蜘蛛池程序会记录百度、Google、Bing等蜘蛛的抓取间隔、并发数、Cookie携带情况,并据此调整页面返回策略。若蜘蛛访问频率异常,程序会自动降速并切换节点。
2. 内容语义图谱化。单纯采集拼接的内容已被识别。当前程序会围绕主站主题生成实体关系图,每个节点页面只覆盖一个长尾实体,并通过结构化数据标注与主站建立语义关联。
3. 链接注入的时机控制。蜘蛛池程序不再一次性放出所有链接,而是根据主站更新频率,分批次在节点页面中插入主站链接。每次插入后,程序会主动向搜索引擎提交节点URL,并监控抓取日志。
4. 反指纹检测。最新程序会检测访问者是否为真实蜘蛛,包括反向DNS验证、IP段匹配、HTTP头顺序、TLS指纹等。只有通过验证的请求才会看到包含主站链接的页面。
四、蜘蛛池程序进入后的操作流程
假设已合法获得最新蜘蛛池程序的调度端访问权限,标准操作流程如下:
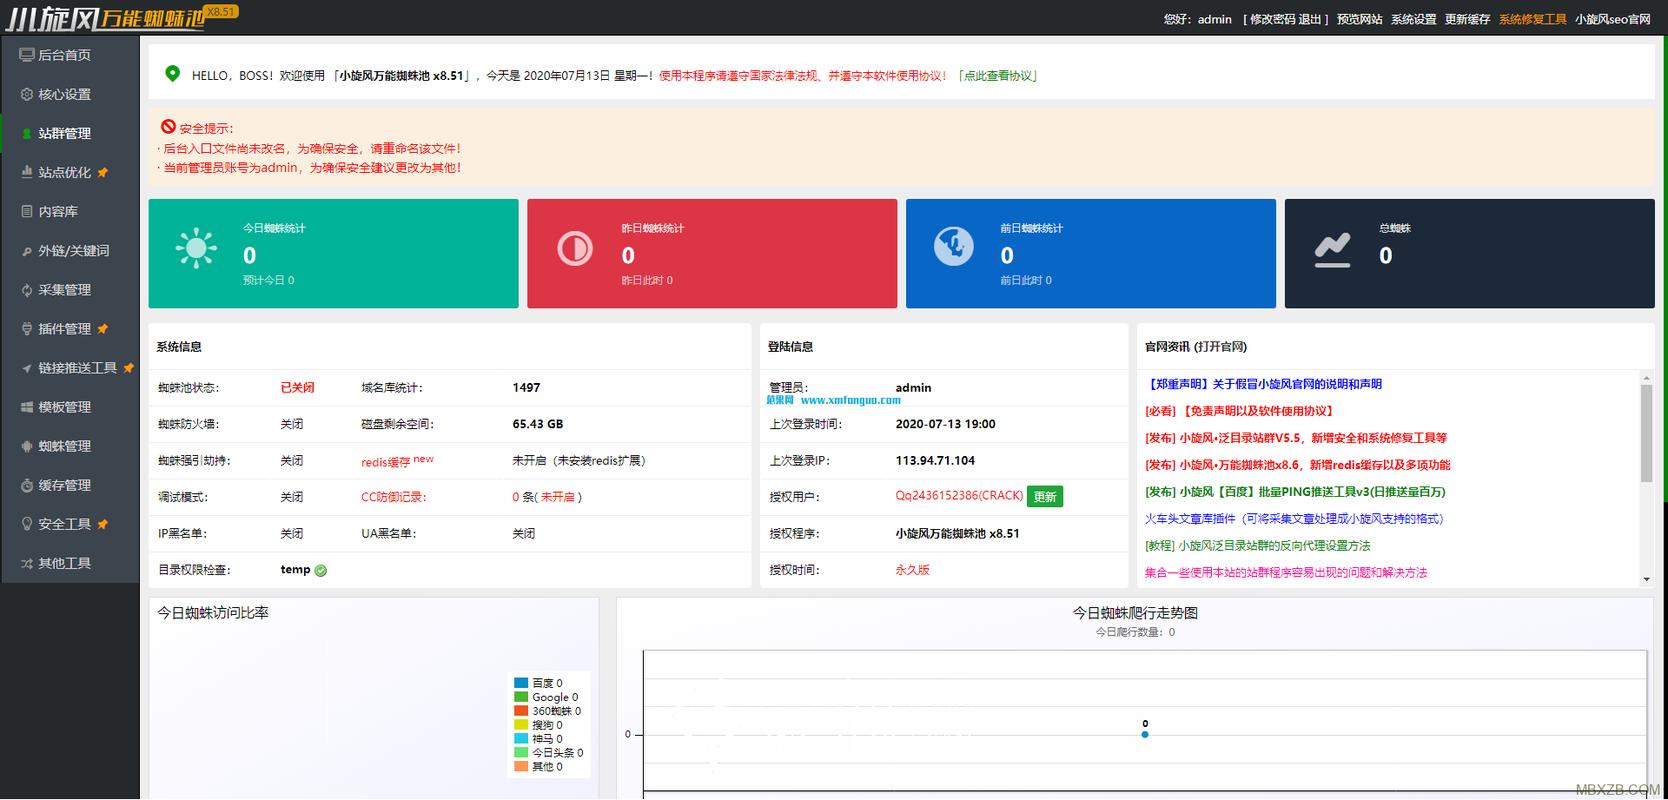
- 登录调度端,进入节点管理页面,添加至少三个不同C段的服务器作为节点。
- 为每个节点配置泛解析域名,并设置DNS轮询策略。
- 在内容模板中导入主站的关键词与实体列表,生成页面骨架。
- 设置蜘蛛触发规则:仅当UA包含百度蜘蛛且IP反向解析为baidu.com时,返回带主站链接的完整页面。
- 启动任务,程序会自动向搜索引擎提交节点URL,并记录每次抓取状态。
- 通过调度端的日志面板观察收录变化,若72小时内无收录,则调整内容密度或更换节点IP。
整个过程中,程序入口仅作为管理通道,真正的收录效果取决于节点质量、内容语义相关性和蜘蛛触发策略。
五、风险与合规提示
必须指出,蜘蛛池技术若用于操纵搜索结果,违反搜索引擎服务条款,可能导致主站被永久降权。2026年搜索引擎已能通过图神经网络识别链接农场,蜘蛛池的生存周期从过去的数月缩短至数周。因此,任何关于“最新蜘蛛池程序怎么进”的讨论,都应限于安全研究、爬虫技术学习或自有网站的收录优化测试。切勿将技术用于攻击、欺诈或侵犯他人权益。
总结而言,最新蜘蛛池程序的入口并非一个公开链接,而是由授权机制、内网访问、API令牌共同构成的受控通道。理解其架构与收录原理,远比寻找一个所谓“入口”更有价值。
亮点功能
- ✦ 百度蜘蛛池搭建图片全流程解析:从零构建高效爬虫池的实战指南
- ✦ 百度蜘蛛池搭建图片全流程解析:从零构建高效爬虫池的实战指南
- ✦ 百度蜘蛛池搭建图片全流程解析:从零构建高效爬虫池的实战指南